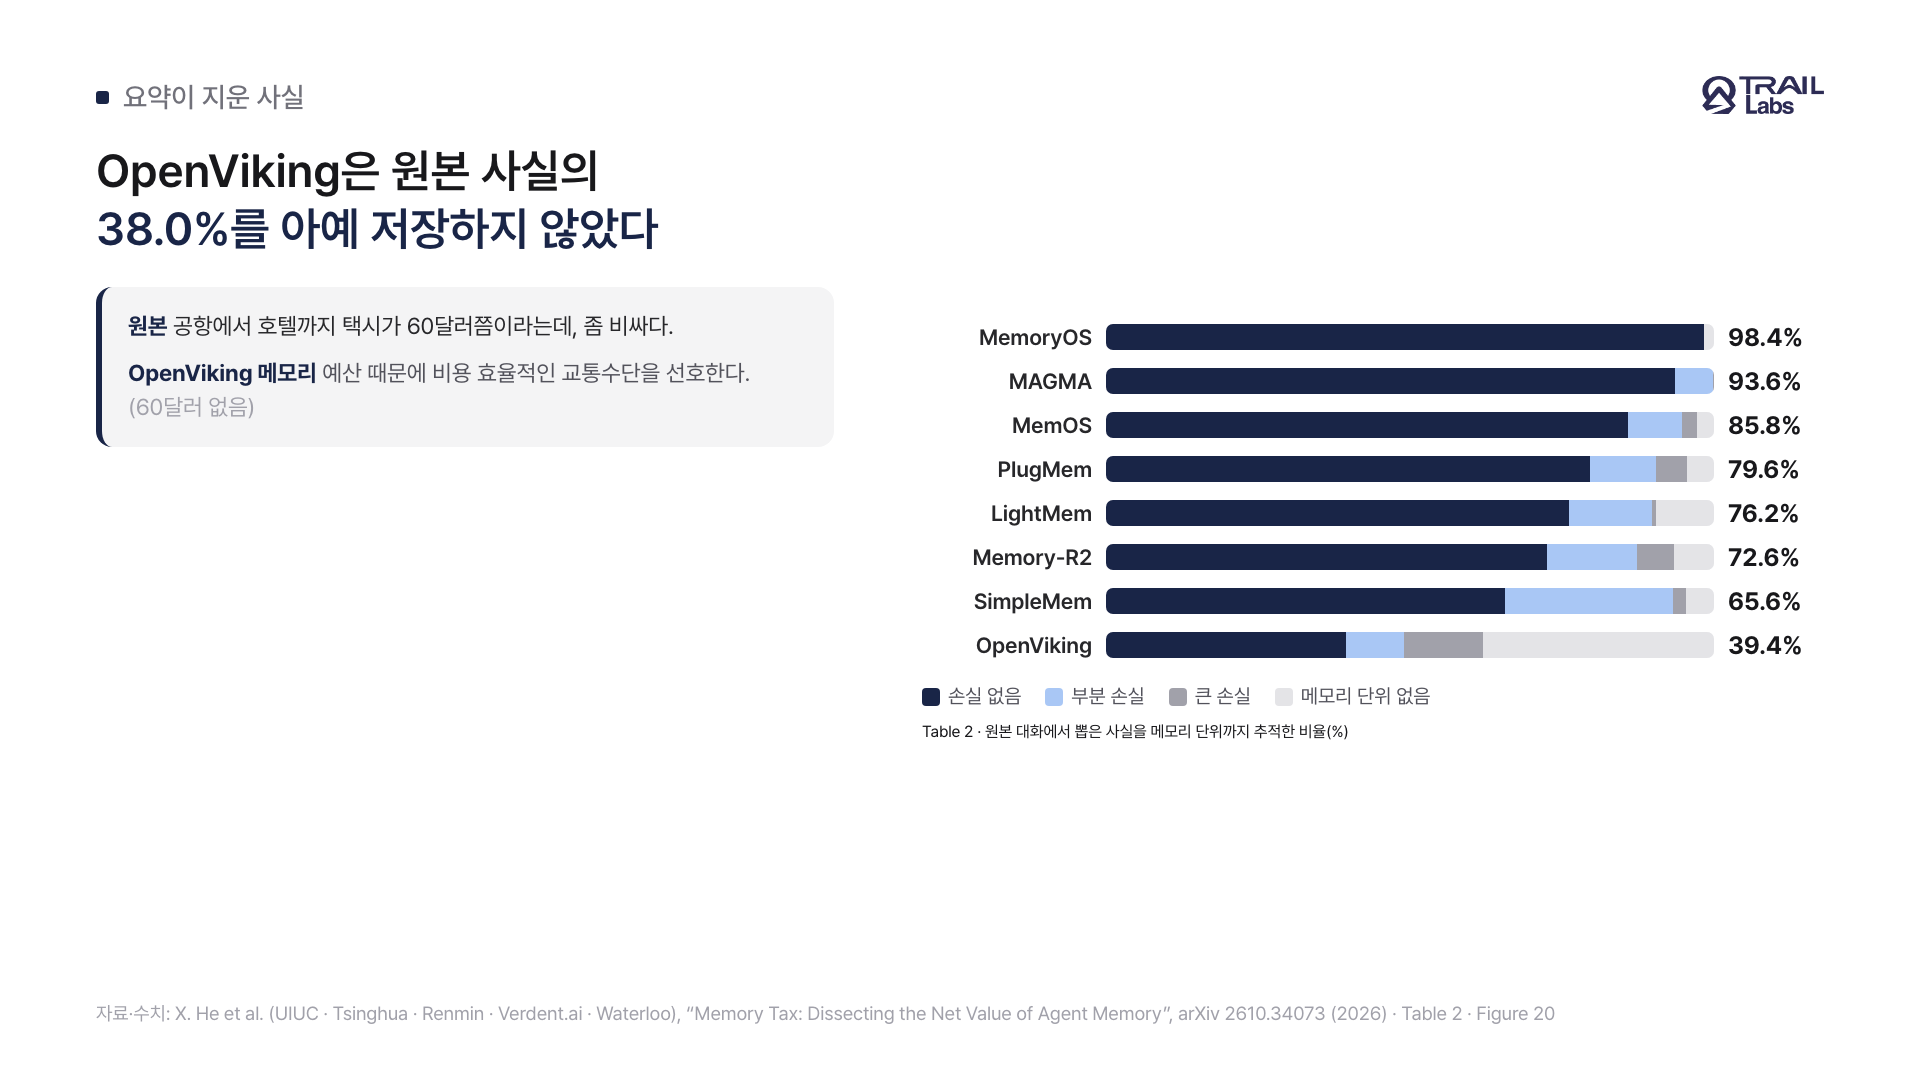
사용자가 “공항에서 호텔까지 택시가 60달러쯤이라는데 좀 비싸다”고 말했다. 한 agent memory 시스템은 이 말을 “예산 때문에 cost-effective한 교통수단을 선호한다”로 저장했다. 며칠 뒤 “기차 타면 얼마 아껴?”라고 물으면, memory 안에는 60이라는 숫자가 없다. 이 장면은 UIUC·Tsinghua 등 다섯 기관이 2026년 10월 25일 arXiv에 올린 “Memory Tax” 논문 부록에 있는 실제 사례다 [1]. peer review 전 preprint이고, 아래는 arXiv v1을 읽으며 표 1·2·4·19의 숫자를 원문과 맞춰 본 메모다. 코드는 돌려 보지 않았고 저자들과 관계는 없다.
요약은 질문을 모른 채 일어난다
택시 사례가 불편한 이유는 그 시스템이 틀린 요약을 한 게 아니라는 데 있다. “가성비를 따지는 사람”이라는 정리는 그럴듯하다. 문제는 요약하는 시점에 나중에 어떤 질문이 올지 모른다는 점이다. 선호를 물으면 이 요약이 맞고, 금액을 물으면 이 요약은 쓸모가 없다.
논문은 이걸 ahead-of-time memory의 본질적인 긴장으로 본다. 질문 전에 가공하면 어떤 가공이 도움이 될지 모르는 채로 정보를 바꾸게 되고, 질문 뒤에 가공하는 just-in-time 방식은 질문을 알지만 latency가 늘어난다 [1]. 저자들은 원본에서 바뀐 모든 것을 deviation이라 부르고, 그게 도움이 되는 쪽(benefit)과 해가 되는 쪽(tax)을 같이 낳는다고 정리했다.
측정 방식이 깔끔하다. 같은 질문을 memory 시스템과 raw history 위의 plain RAG에 같이 돌려서, memory만 맞힌 비율을 $B$, RAG만 맞힌 비율을 $T$로 두고 순가치를 $B - T$로 본다 [1]. 평균 accuracy가 같아도 두 시스템이 서로 다른 질문을 맞힐 수 있으니, 이렇게 query 단위로 갈라야 무엇을 얻고 무엇을 잃었는지 보인다.
숫자로 보면 tax가 benefit보다 컸다
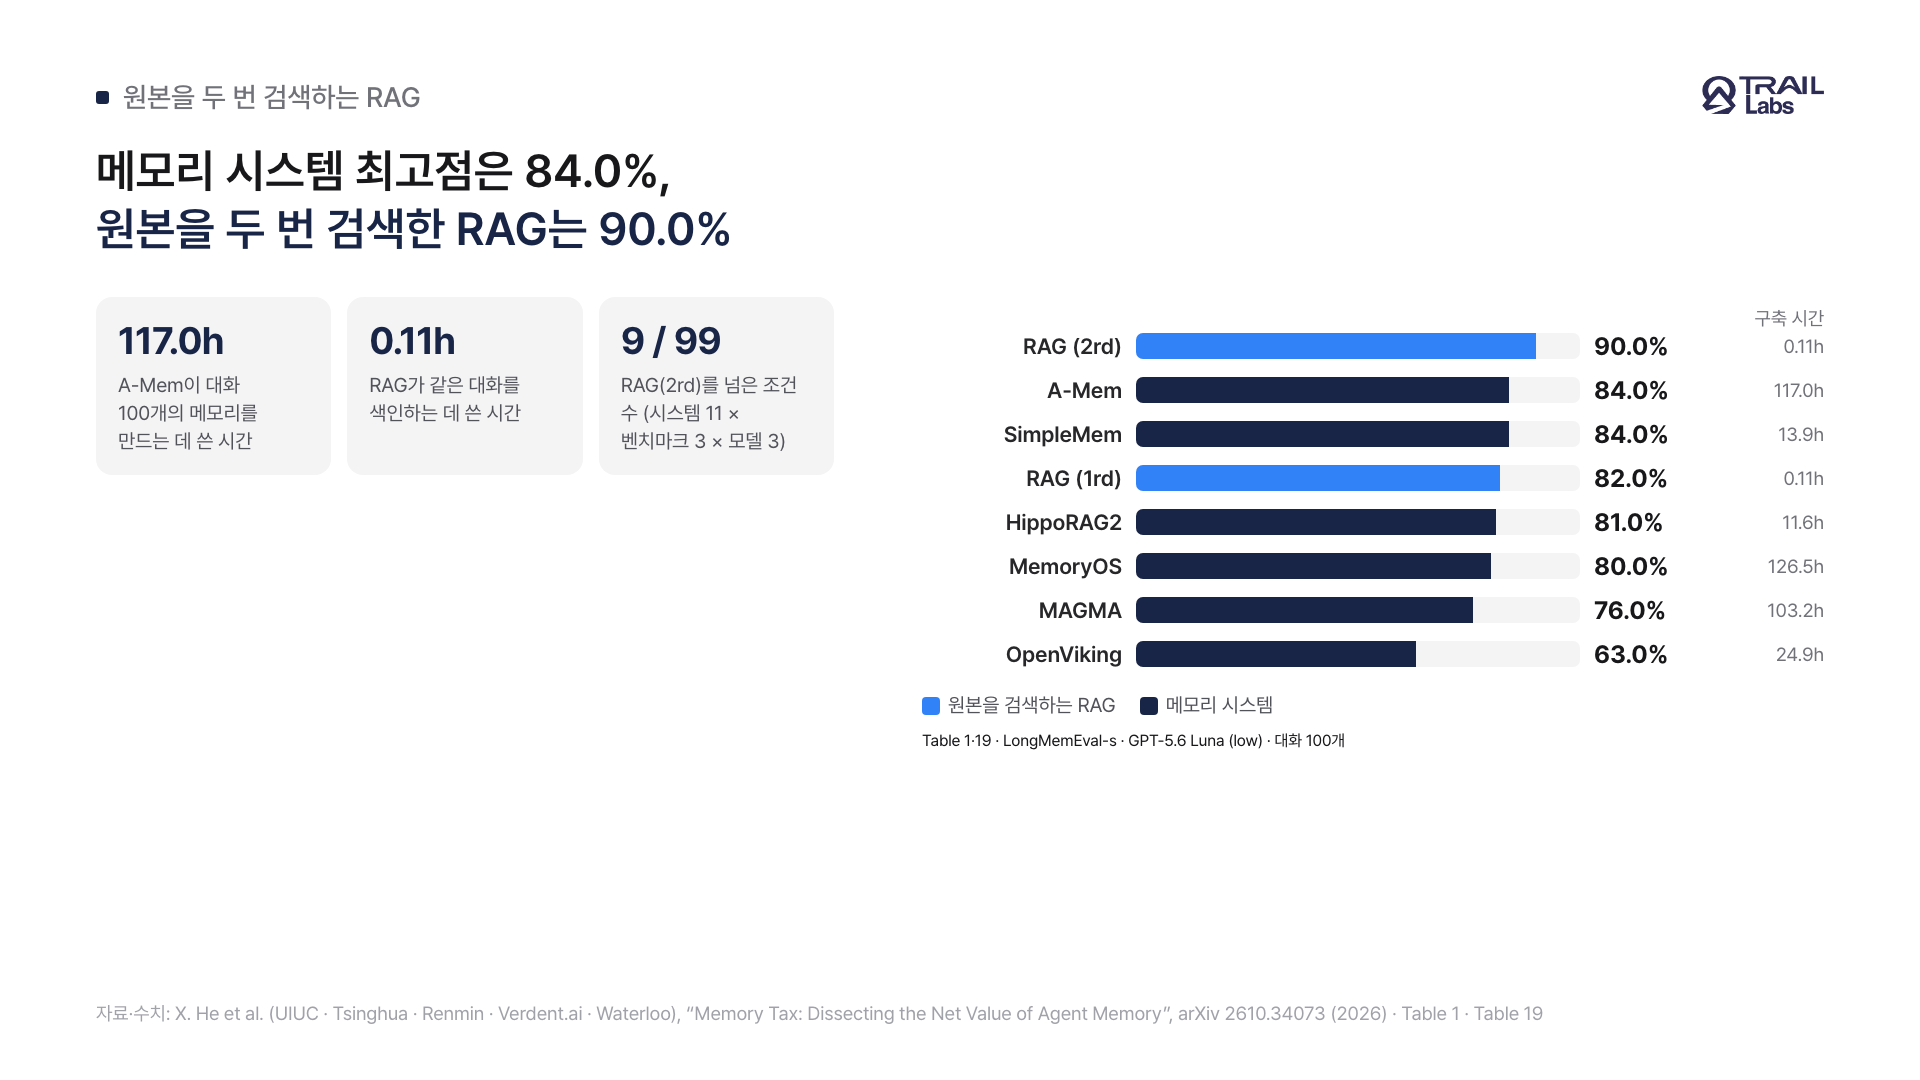
memory 시스템 11종(A-Mem, SimpleMem, MemOS, MemoryOS, LightMem, OpenViking, HippoRAG2, PlugMem, MAGMA, Mem-T, Memory-R2)을 benchmark 3개(LongMemEval-s, PersonaMem-v2, MINT-Eval)와 backbone 3개(Qwen3.5-4B, Qwen3.6-27B, GPT-5.6 Luna low)로 돌렸다 [1]. 표 1의 99칸을 세어 보면, 두 번 검색하는 RAG를 넘은 칸이 9개다. 나머지 90칸에서는 memory가 같거나 낮았다.
| LongMemEval-s 정확도 (Luna) | 원본 사실이 손실 없이 남은 비율 | memory 구축 시간 (대화 100개) | |
|---|---|---|---|
| RAG, 2 rounds | 90.0% | 원본 그대로 | 0.11h (indexing) |
| A-Mem | 84.0% | 표 2에 없음 | 117.0h |
| MemoryOS | 80.0% | 98.4% | 126.5h |
| MAGMA | 76.0% | 93.6% | 103.2h |
| SimpleMem | 84.0% | 65.6% | 13.9h |
| OpenViking | 63.0% | 39.4% | 24.9h |
이 표에서 내가 본 건 두 가지다. 하나는 비용이다. A-Mem은 LLM을 약 9만 8천 번 부르며 117시간을 썼는데, RAG는 같은 대화를 0.11시간 만에 indexing하고 약 200번 호출로 끝냈다 [1]. 다른 하나는 MemoryOS다. 원본 사실을 98.4% 보존했는데도 정확도는 80.0%로 RAG에 못 미쳤다. 정보를 잃지 않아도 진다는 뜻이고, 이건 다음 절의 이야기다.
남아 있어도 못 찾는다
정보가 살아남아도 retrieval이 늦게 잡으면 소용이 없다. 부록의 자전거 사례가 그렇다. 원본은 “4월 20일 정비 때 chain 교체 25달러, light 설치 40달러”라는 한 문단이었는데, PlugMem은 이걸 memory unit 세 개로 쪼갰고, 총액 계산에 필요한 25달러 unit은 네 번째 retrieval round에서야 돌아왔다 [1].
저자들은 이걸 fragmenting, diluting, rephrasing으로 나눴다. 쪼개지고, 관련 없는 정보와 섞이고, 다른 말로 바뀌면서 같은 근거가 query와 덜 맞물린다. 그래서 gold memory unit을 직접 넣어 주면 MAGMA와 LightMem은 원본 수준까지 올라간다 [1]. 저장은 됐는데 찾을 수가 없었던 것이다.
어제 읽은 retrieval bottleneck 논문과 겹치는 지점이 여기다. 그 논문은 chunking이 근거를 흩어 놓는다고 했고, 이 논문은 LLM 요약이 그 흩어짐을 한 번 더 만든다고 보여 준다. RAG든 memory든 결국 retrieval이 상한선을 정한다.
지우라는 말을 기억하는 memory
개인적으로 가장 오래 붙잡은 사례는 따로 있다. 사용자가 “결혼 압박 얘기는 잊어 줘”라고 하자, SimpleMem은 그 요청을 같은 내용에 대한 새 사실로 저장했고 PlugMem은 요청은 버리고 지워야 할 내용만 남겼다 [1].
정확도 표에는 거의 안 잡히는 실패지만, 실제로 개인 agent를 운영하면 이쪽이 더 무섭다. 삭제 요청이 저장소에 “삭제해 달라고 한 내용” 형태로 남으면, 원본을 지워도 요약본 어딘가에 흔적이 산다. 요약형 memory에서 delete는 단순한 row 삭제가 아니라, 그 사실에서 파생된 모든 unit을 추적해야 하는 일이 된다.
내가 memory를 짠다면
나도 매일 agent를 쓰면서 작업 기억을 짧은 요약 파일로 남긴다. “이 사람은 이렇게 일한다” 같은 문장들이다. 이 논문을 읽고 나니 그 문장들이 원래 대화의 어떤 숫자와 조건을 버렸을지부터 떠올랐다. 그래서 설계를 바꾼다면 이렇게 하겠다.
- raw log는 append-only로 둔다. 요약은 원본을 대체하지 않고, 원본 span을 가리키는 index로만 쓴다. summary마다 어느 turn에서 나왔는지 pointer를 단다.
- 답할 때 raw도 같이 검색한다. 논문의 src-aug가 정확히 이거다. memory와 원본을 함께 검색해 rerank했더니 SimpleMem은 73.6%에서 82.8%로, tax는 12.0%에서 5.2%로 내려갔다(LongMemEval-s, Qwen3.6-27B) [1]. 구조를 새로 만들 필요도 없었다.
- 어렵게 찾은 경로는 저장한다. 여러 round 만에 찾은 근거와 그때의 query를 memory에 다시 넣으면, 비슷한 질문은 한 번에 찾는다. 논문의 recursive 방식은 PersonaMem-v2에서 세 시스템의 정확도를 모두 올렸지만 폭은 작았다. Mem-T가 42.1%에서 45.7%로 가장 컸고, SimpleMem은 0.1점이었다 [1].
- 평가에는 RAG baseline을 항상 같이 둔다. memory끼리만 비교하면 tax가 안 보인다. query 단위로 benefit과 tax를 따로 세야 memory가 실제로 무엇을 사 왔는지 알 수 있다.
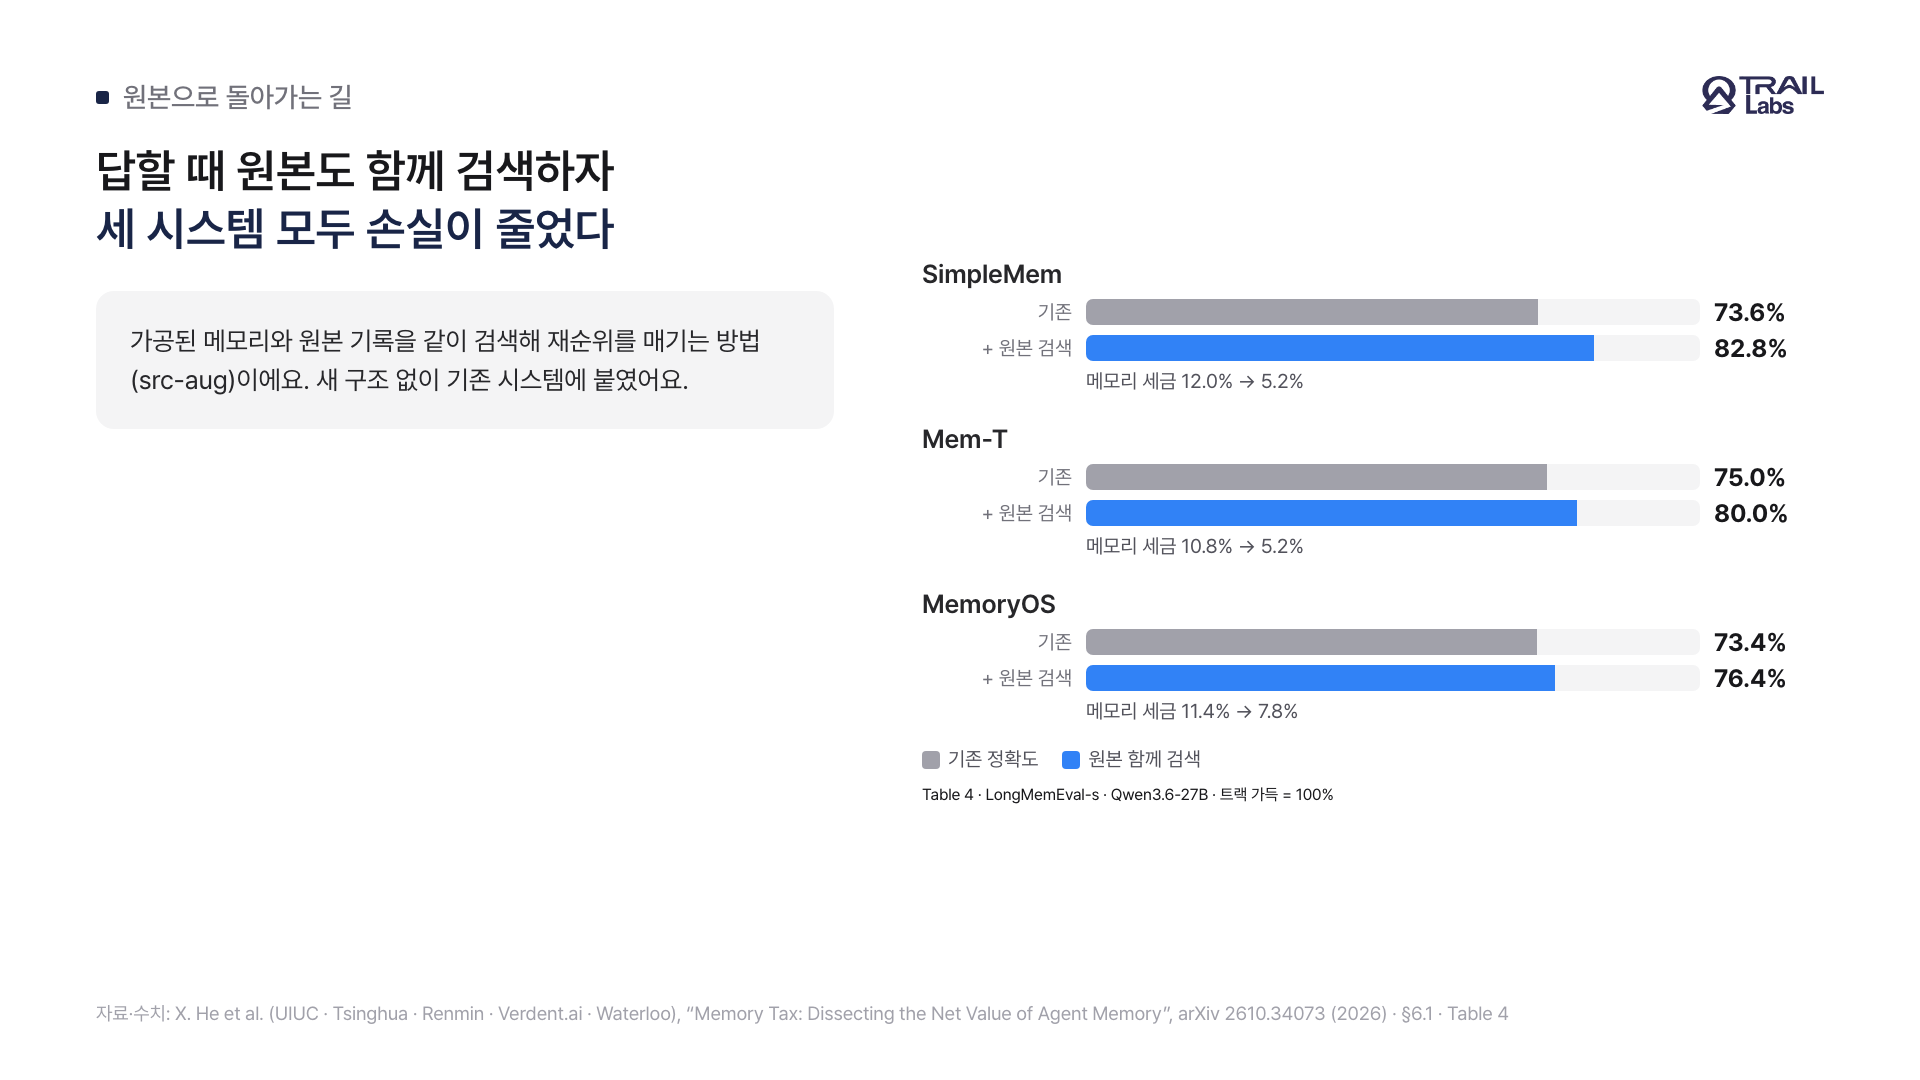
지식 문서를 다룰 때도 같은 원칙을 쓰고 있다. LLM wiki 글에서 정리한 것처럼 raw source 폴더는 고치지 않고, 정리한 문서마다 출처를 단다. 요약은 찾아가는 길이고, 답은 원문에 있다.
이 결과를 어디까지 믿을까
저자들도 benchmark가 retrieval에 유리하다는 걸 인정한다. 드문 키워드만 맞추는 IDF baseline이 일부 benchmark에서 50%를 넘었고, hybrid RAG는 약 70%에 이르렀다 [1]. 이미 단순 검색으로 풀리는 질문이 많으면 memory가 얻을 여지가 작고, 작은 손실이 그대로 드러난다. 실제로 과거 작업 trajectory를 workflow로 정리하는 experiential memory는 web task(WebShop, Mind2Web)에서 RAG를 앞서기도 했다 [1].
표본도 줄였다. PersonaMem-v2는 20%, MINT-Eval은 10%, Luna 조건의 LongMemEval-s는 대화 100개만 썼고, 가장 강한 모델이 GPT-5.6 Luna(low)였으며, 채점은 Qwen3.6-27B 기반 LLM judge다. 대화는 대부분 영어·offline이다 [1]. 그래서 나는 이 숫자를 “memory를 버리고 RAG를 써라”로 읽지 않는다. memory를 만들 거면 원본으로 돌아갈 길과 RAG baseline을 같이 두라는 쪽으로 읽는다.