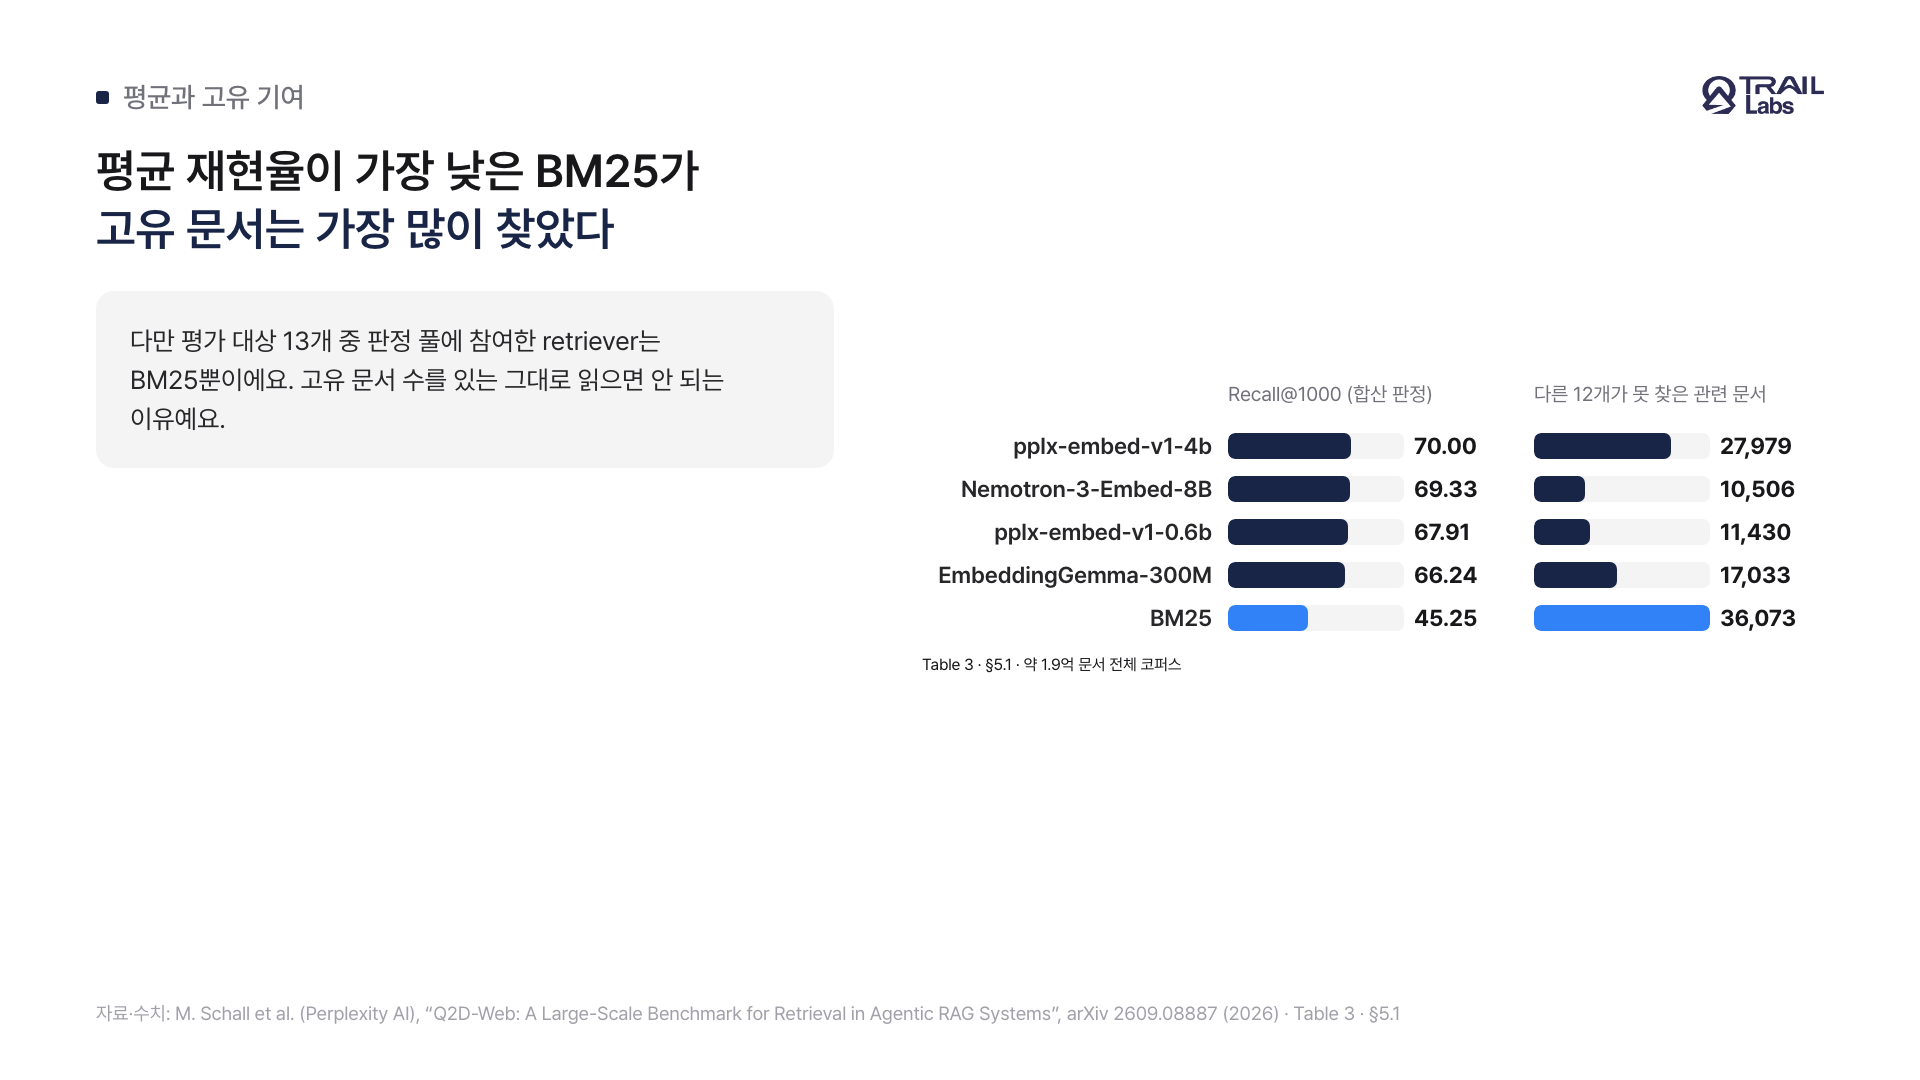
1.9억 문서 benchmark에서 BM25는 Recall@1000 45.25로 13개 retriever 중 꼴찌인데, 다른 모델이 못 찾은 relevant document는 36,073건으로 1등이었다 [1]. “그래서 hybrid를 써야 한다”로 바로 넘어가기 좋은 숫자다. 그런데 이 표를 만든 judgment pool을 보면 그렇게 빨리 넘어갈 수가 없다. Perplexity 연구진의 Q2D-Web v2를 2026년 11월에 읽고 표 1–3과 Figure 7·8의 숫자를 맞춰 본 메모다. peer review 전이고, 데이터가 비공개라 재현은 못 했다. 저자들과 관계는 없다.
먼저, 왜 unique positive가 의심스러운가
relevant label은 세 군데에서 온다. agent가 cite한 문서, production ranking 상위 문서, 그리고 그 둘에 없는 후보를 LLM이 판정한 문서다 [1]. 문제는 뒤의 두 개다.
- LLM에게 보낼 후보는 2025년 이전 모델 9개의 ranking을 RRF로 합쳐 뽑았다. 평가 대상 13개와 겹치는 건 BM25 하나다 [1].
- production ranking의 first stage는 BM25와 dense retrieval을 함께 쓴다 [1].
즉 BM25가 찾은 문서는 label을 받을 경로가 다른 모델보다 많다. 평가 대상인 신형 neural model이 혼자 찾아낸 문서는 후보에 오르지 못하면 unjudged로 남고, 관례상 non-relevant로 계산된다. 저자들이 temporal holdout으로 평가 모델의 편향을 줄인 건 좋은 설계지만, 이 구조에서는 BM25만 예외가 된다. 이게 36,073을 얼마나 부풀렸는지는 논문만으로 알 수 없다. 다만 내가 이 숫자를 그대로 인용하지 않는 이유로는 충분하다.
규모도 본다. query 69,721개에 query당 positive 88.5개면 판정은 약 617만 쌍이고, 36,073은 1%가 안 된다(내 계산). 그리고 저자들 스스로 BM25를 ensemble에 넣으면 recall이 오르는지는 검증하지 않았고, 같은 개수·같은 fusion·같은 candidate budget으로 비교해 보라고 후속 과제로 남겼다 [1]. 논문의 결론도 “useful할 수 있다”까지다.
그래도 믿는 부분: query가 다르다
이 benchmark에서 내가 제일 쓸모 있게 본 건 모델 순위가 아니라 query 분포다. 모든 query를 agent가 썼고, primary가 12,365개(17.7%), support가 57,356개(82.3%)다 [1]. 대부분의 embedding model은 사람이 쓴 query로 학습됐는데, production first stage가 실제로 받는 입력은 대부분 이쪽이다.
Figure 8을 읽으면 neural model은 전부 support에서 낮고 BM25만 올라간다. 그런데 폭을 보면 저자들의 “substantially”보다 작다. Qwen3-0.6B가 61.3에서 58.1로 3.2포인트, pplx-late는 64.6에서 64.1로 0.5포인트다 [1]. 방향은 일관되지만, 이것만으로 모델을 바꿀 근거는 아니다. 내 평가 셋에 agent query가 없다면 그걸 먼저 넣겠다는 정도의 신호로 읽는다.
지표를 바꾸면 1등이 바뀐다
| Retriever | Recall@1000 | Recall@100 | nDCG@10 |
|---|---|---|---|
| pplx-embed-v1-4b | 70.00 | 30.17 | 44.12 |
| Nemotron-3-Embed-8B | 69.33 | 30.32 | 45.65 |
| EmbeddingGemma-300M | 66.24 | 27.70 | 41.95 |
| BM25-tantivy | 45.25 | 18.33 | 29.27 |
Combined label, full corpus 기준이다 [1]. 저자 회사 모델이 primary metric에서 1등이고, 다른 두 지표에서는 Nemotron이 1등이다. reranker를 뒤에 붙일 거면 Recall@1000을 보고, 단독으로 쓸 거면 nDCG@10을 보는 게 맞으니 “최고 모델”은 파이프라인을 정해야 답이 나온다. 300M짜리 EmbeddingGemma가 Recall@1000 4위인 건 비용을 생각하면 눈여겨볼 만하다. full corpus pass가 pplx-4b는 4,608 GPU-hour, EmbeddingGemma는 200시간 미만이다 [1].
놓친 문서를 볼 때 512 token을 빼놓으면 안 된다
13개 모두 top-1000에 넣지 못한 relevant document가 298,868건(6.3%)이다. 표본 4,000건을 LLM으로 분류하면 lexical gap 28.3%, reasoning 21.7%, truncation 18.2%다 [1].
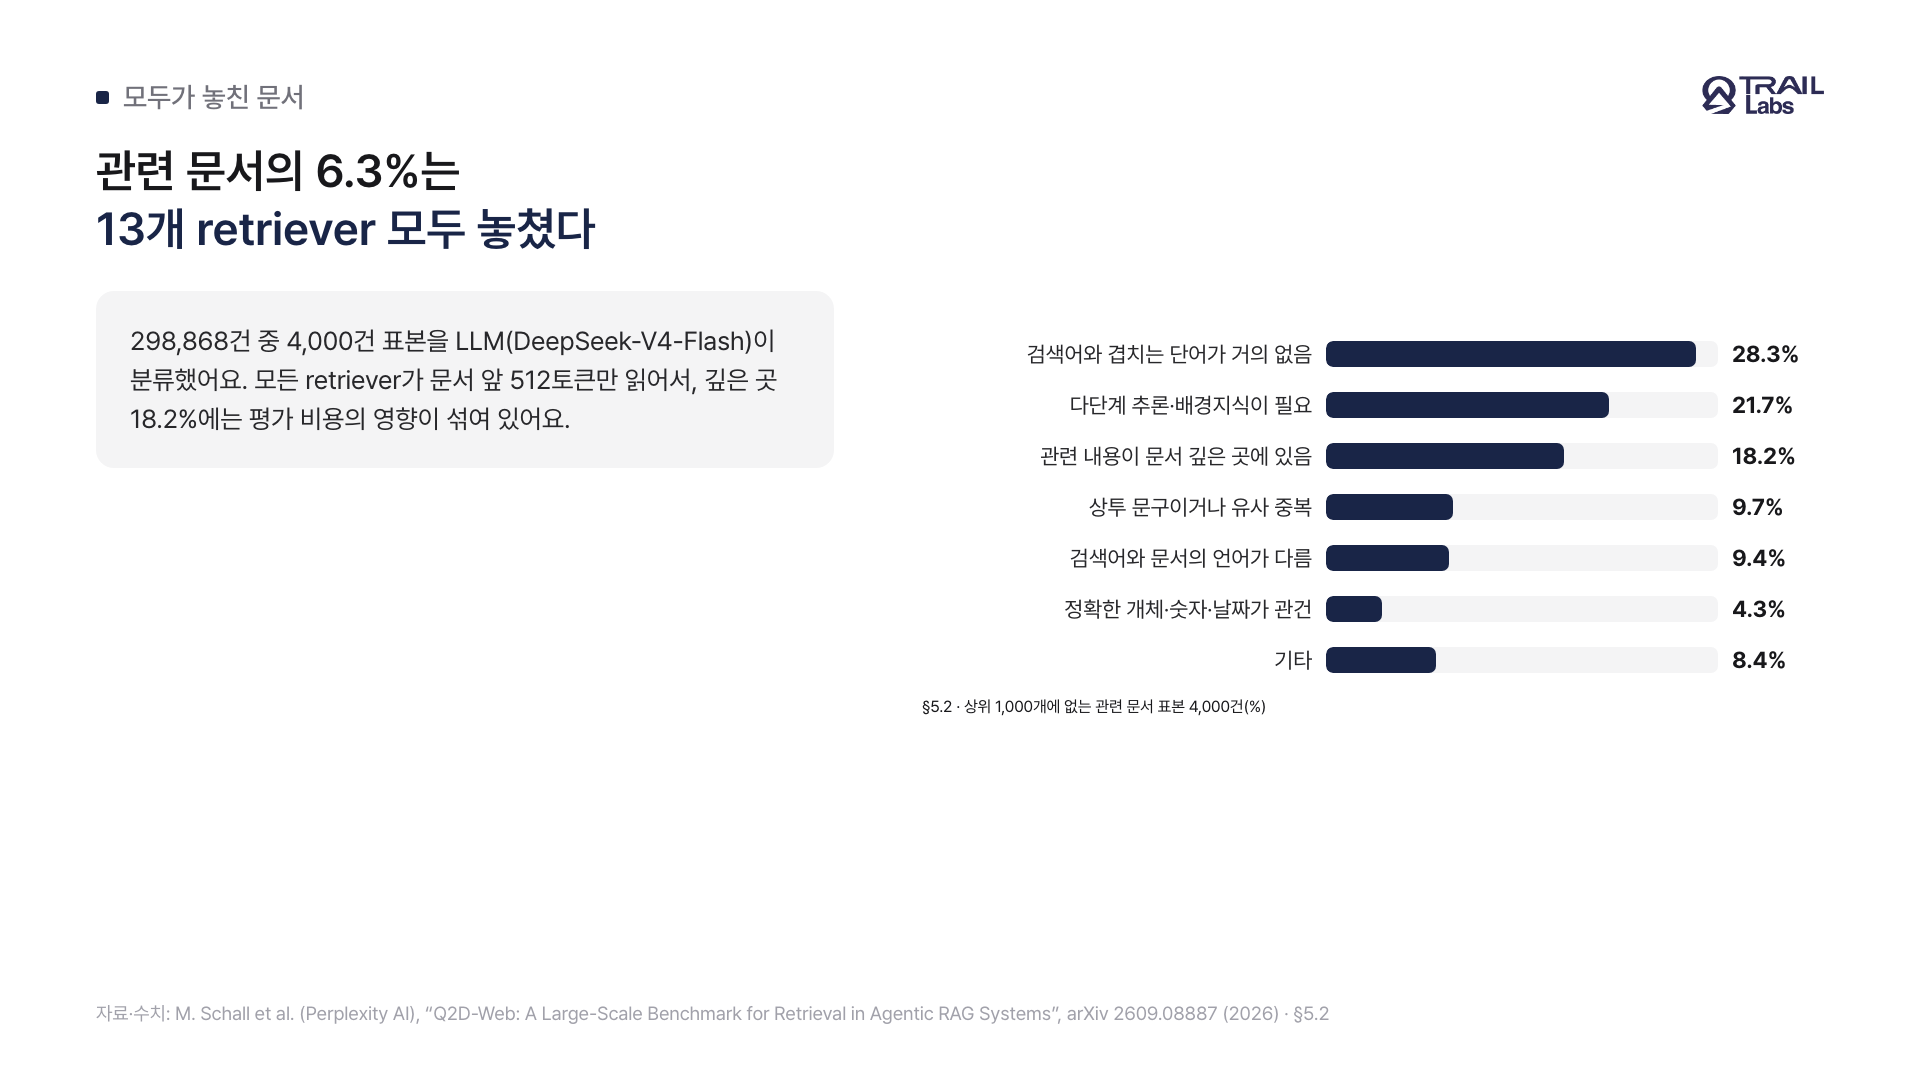
truncation은 설정의 영향을 같이 읽어야 한다. 비용 때문에 전 모델이 문서 앞 512 token만 encode했고, 평균 문서는 3.3k token쯤이다. 저자들도 512 token 점수가 full document 성능의 비편향 추정치라고 주장하지 않는다 [1]. 이 분류를 한 모델이 label을 만든 모델과 같다는 점도 기억해 둔다. 그래도 내 retriever를 점검한다면 첫 줄은 chunking과 truncation이다. 앞서 읽은 retrieval bottleneck 논문과 같은 쪽을 가리킨다.
그리고 cited label의 정의가 재미있다. agent는 claim이 뒷받침되면 cite를 멈추므로, 내용이 겹치는 relevant document는 uncited로 남아 non-relevant가 된다 [1]. 같은 모델이 Citation label에서 85.03, Web Ranking에서 65.73인 이유 중 하나일 것이다. citation을 정답으로 쓰는 평가를 볼 때마다 이 점을 먼저 확인하게 될 것 같다.
한국어 칸은 따로 봤다
한국어 사용자로서 Figure 7의 언어 칸을 찾아봤다. top model과 BM25의 격차가 영어는 26포인트(71, 45)인데 한국어는 13포인트(68, 55)다 [1]. 일본어 18, 중국어 18과 비교해도 작다. 형태소 분석이 원인일 수도, corpus 구성이 원인일 수도 있지만 저자들은 분석하지 않았고, 한국어는 query의 2.2%다. 다만 내가 한국어 RAG를 짠다면 lexical 경로를 먼저 빼는 결정은 측정 없이 안 하겠다.
내가 retriever를 고른다면
- 평가 query에 agent가 쓴 support query를 넣는다. 사람 query만으로 고른 모델은 실제 입력의 일부만 본 것이다.
- judgment pool에 누가 들어갔는지부터 본다. pool에 들어간 모델은 unique positive에서 유리하다. ensemble 판단은 같은 budget의 비교 실험으로 한다.
- metric은 파이프라인 단계에 맞춘다. first stage면 deep recall, 단독이면 nDCG@10이다.
- 언어별로 나눠 잰다. 영어 평균으로 고른 모델이 내 언어에서 같은 순서라는 보장이 없다. mDenseOn은 영어 64%, 다른 언어에서 49–57%였다 [1].
Q2D-Web의 corpus·query·judgment는 전부 비공개다. 저자들은 training contamination을 막기 위해서라고 설명하는데, 말이 되는 이유지만 위의 pool 문제를 외부에서 검증할 수 없다는 뜻이기도 하다 [1]. 공개 leaderboard가 있으니 순위는 거기서 보되, 내 데이터로 다시 재기 전까지 나는 이 표를 방향 정도로만 쓰려고 한다.