Karpathy가 개인 연구용으로 보여준 LLM wiki는 raw source를 모아두면 LLM이 markdown wiki를 쓰고 계속 고치는 방식이고, Google은 이 pattern을 Open Knowledge Format(OKF)이라는 open specification으로 정리해 다른 도구와 조직이 그대로 주고받을 수 있게 했다 [1][3]. repository 기록상 7월에 반영된 v0.2는 agent가 쓰는 문서가 늘어나는 상황을 전제로, 누가 썼고 어디서 왔고 누가 확인했는지를 frontmatter에 적는 field를 더했다 [4]. 그런데 Google 자신의 공개 sample에서도 그 field는 아직 비어 있었다 [5].
LLM pipeline을 짜다 보면 결국 같은 질문에 닿는다. agent가 참고할 지식을 어떤 모양으로 두어야 사람도 읽고 agent도 읽고, agent가 고쳐 쓴 뒤에도 믿을 수 있나. 그래서 Karpathy의 X 게시물과 gist, Google Cloud blog, OKF specification(SPEC.md)을 2026년 10월에 읽고 서로 대조했다 [1][2][3][4]. sample bundle 집계는 공식 repository의 commit 5d1345c를 받아 내가 직접 센 값이다 [5]. OKF tooling은 직접 써보지 않았고, Google과 관계는 없다.
LLM wiki는 RAG와 어떻게 다른가
LLM wiki는 질문할 때마다 원문을 다시 찾는 대신, LLM이 raw source를 한 번 정리해둔 wiki를 계속 고쳐가며 그 위에서 답하는 방식이다 [2]. Karpathy는 2026년 4월 2일 X에 “LLM Knowledge Bases”라는 글을 올려, 최근 token 사용의 상당 부분이 code보다 지식을 다루는 데 들어간다고 적었다 [1]. 흐름은 이렇다. source를 raw/ 폴더에 모으고, LLM이 요약·backlink·concept article로 된 markdown wiki를 “compile”하고, 그 wiki에 질문하고, 답을 다시 wiki에 쌓는다 [1].
규모에 대한 관찰이 구체적이다. 그의 연구 wiki는 약 100편, 40만 단어였고, 처음엔 정교한 RAG가 필요할 거라 생각했지만 그 규모에서는 LLM이 index file과 문서별 짧은 요약을 스스로 관리하는 것만으로 관련 자료를 충분히 읽어냈다고 한다 [1]. wiki는 LLM이 쓰고 고치고, 본인은 거의 손대지 않는다 [1].
함께 공개한 gist “LLM Wiki”는 이를 세 층으로 나눈다 [2]. raw source는 고치지 않는 source of truth이고, wiki는 LLM이 전부 소유하는 markdown directory이고, schema(CLAUDE.md나 AGENTS.md 같은 파일)는 wiki의 구조와 workflow를 LLM에게 알려주는 설정이다 [2]. 작업은 ingest, query, lint 세 가지이고, lint는 page 사이의 모순, 새 source가 덮어쓴 낡은 주장, inbound link가 하나도 없는 orphan page를 찾는 일이다 [2].
Karpathy는 RAG와의 차이를 “쌓이느냐”로 설명한다. NotebookLM이나 upload형 RAG는 다섯 문서를 엮어야 하는 질문이 오면 매번 조각을 다시 찾아 이어 붙이지만, LLM wiki는 cross-reference와 모순 표시가 이미 들어간 상태에서 출발한다 [2]. 사람이 wiki를 포기하는 건 읽고 생각하는 비용보다 장부 정리 비용 때문이고, LLM은 지루해하지 않고 한 번에 파일 15개를 고칠 수 있으니 그 비용이 거의 0이 된다는 게 그의 논지다 [2]. 문서가 낡는 건 대개 쓰기 싫어서가 아니라 고칠 곳을 다 찾아다니기 귀찮아서다.
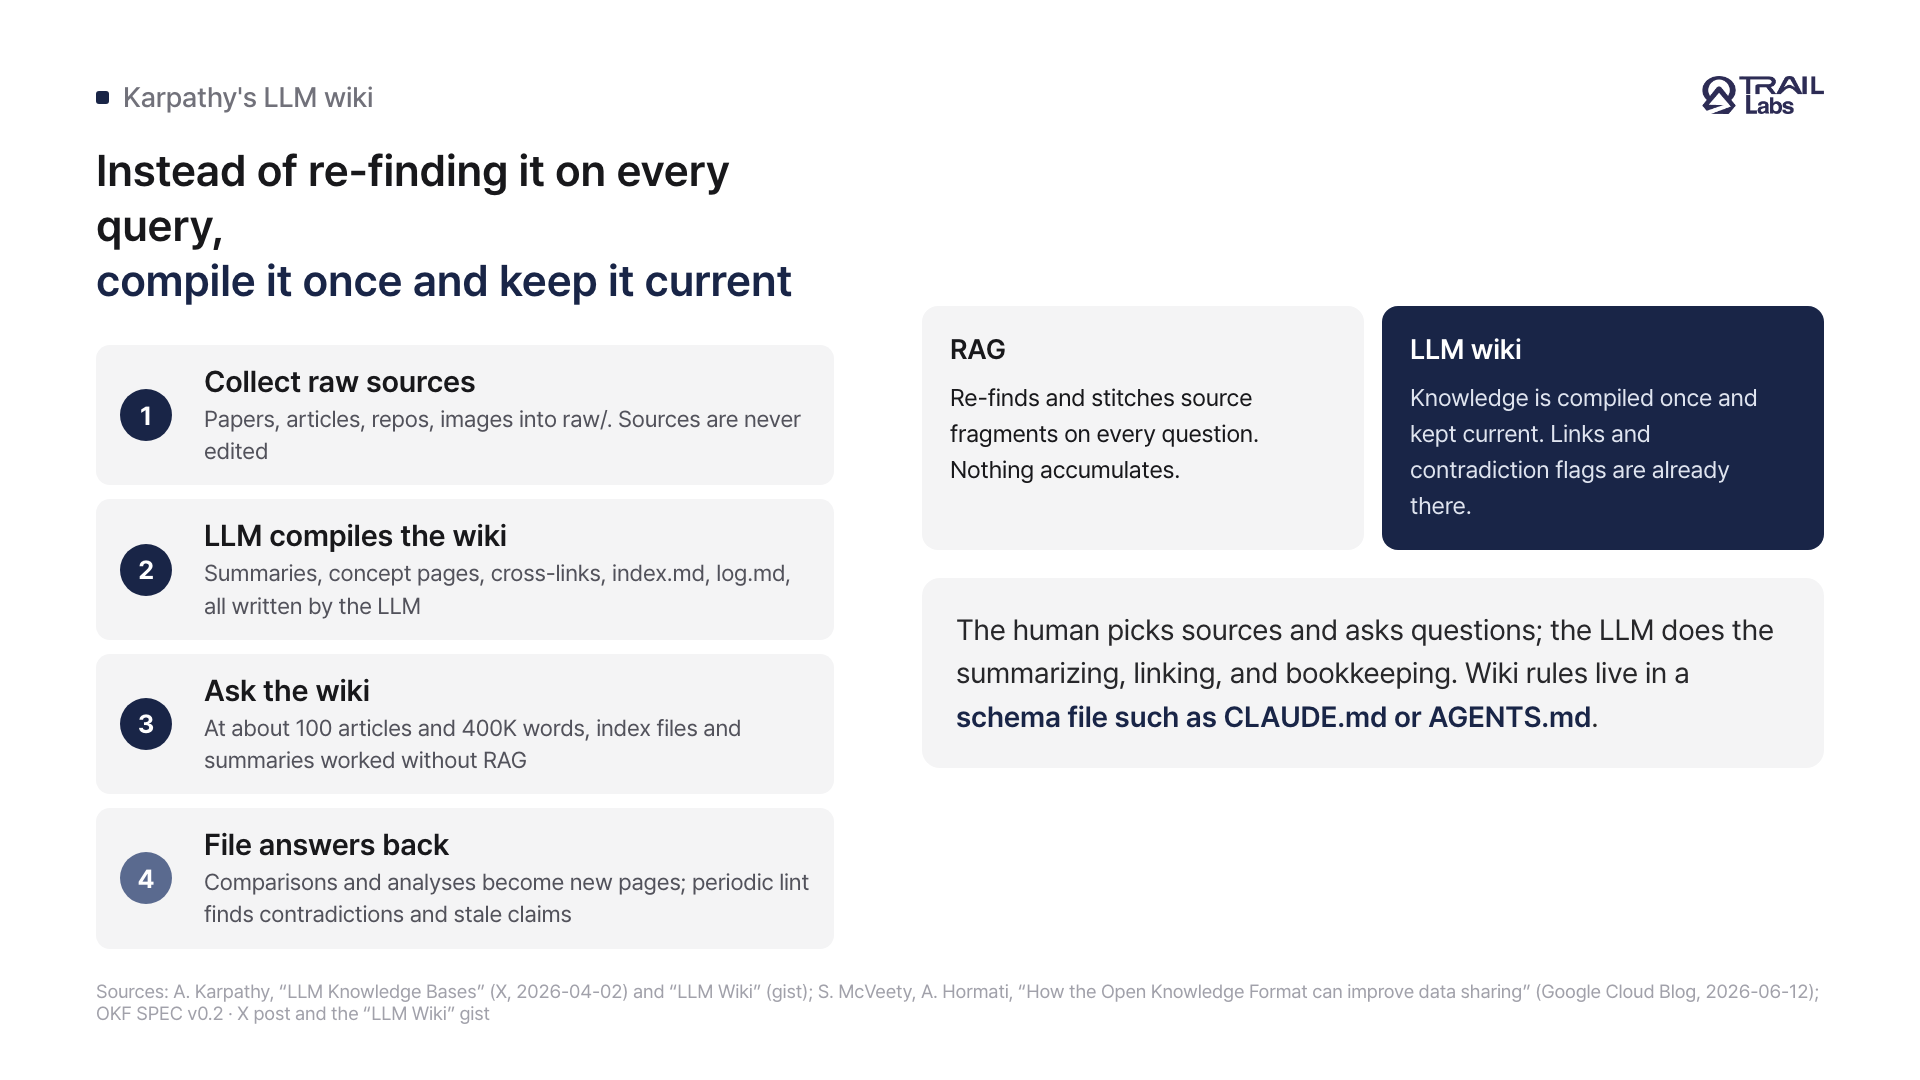
그림 1. LLM wiki는 raw source를 한 번 정리한 wiki를 계속 고치고, 답도 다시 wiki에 쌓는다 [1][2].
Open Knowledge Format은 무엇인가
OKF는 LLM wiki pattern을 서로 다른 producer와 consumer가 번역 없이 주고받게 만든 open specification이다 [3]. Google Cloud Data Cloud 팀의 Sam McVeety와 Amir Hormati가 2026년 6월 12일 Google Cloud blog에서 v0.1을 발표하면서 Karpathy의 gist를 직접 인용했다 [3]. 문제의식은 이렇다. Karpathy의 wiki, 팀 wiki, vendor의 catalog export가 모두 markdown·frontmatter·cross-link로 비슷하게 생겼지만 서로 협력하도록 설계되지 않아서, 문서마다 어떤 field를 두는지, 어떤 파일명이 무슨 뜻인지 합의가 없다 [3].
그래서 OKF는 service가 아니라 format을 내놓았다 [3]. bundle은 markdown 파일이 든 directory이고, 파일 하나가 concept 하나이며, file path가 그 concept의 identity다 [4]. frontmatter에서 필수는 type 하나이고 title·description·resource·tags는 권장이다 [4]. index.md(progressive disclosure용 directory 목록)와 log.md(변경 이력)는 예약 파일명이고, concept끼리는 일반 markdown link로 이어져 폴더 tree보다 풍부한 graph가 된다 [4].
| Karpathy의 LLM wiki | OKF의 대응 | 비고 |
|---|---|---|
| concept·요약 page | concept 문서, type 필수 | file path가 identity |
| index.md | index.md 예약 파일명 | 폴더마다 둘 수 있음 |
| log.md | log.md 예약 파일명 | 날짜별 변경 이력 |
| raw/ source | sources field, references/ 관례 | v0.2에서 frontmatter로 이동 |
| lint(모순·낡은 주장) | status, stale_after, verified | v0.2, lint 절차 자체는 규정하지 않음 |
| schema 파일(CLAUDE.md, AGENTS.md) | 규정하지 않음 | producer 몫 |
표 1. Karpathy가 gist에서 설명한 wiki 요소와 OKF specification의 대응 [2][4]. 대응 관계는 두 문서를 대조해 내가 정리한 것이다.
설계 원칙은 세 가지다. 최소한만 정한다(필수는 type 하나). producer와 consumer가 서로 독립적이다(사람이 쓴 bundle을 agent가 읽고, 한 LLM이 만든 bundle을 다른 LLM이 query한다). platform이 아니라 format이다(독점 계정이나 SDK 없이 읽고 쓴다) [3]. 함께 공개된 것은 BigQuery dataset을 돌며 table마다 concept 문서를 쓰고 공식 문서로 보강하는 reference agent, bundle을 graph로 보여주는 정적 HTML viewer, sample bundle이다 [3]. repository는 Apache-2.0이고, Google Cloud Knowledge Catalog가 OKF를 ingest하도록 바뀌었다고 blog는 밝힌다 [3].
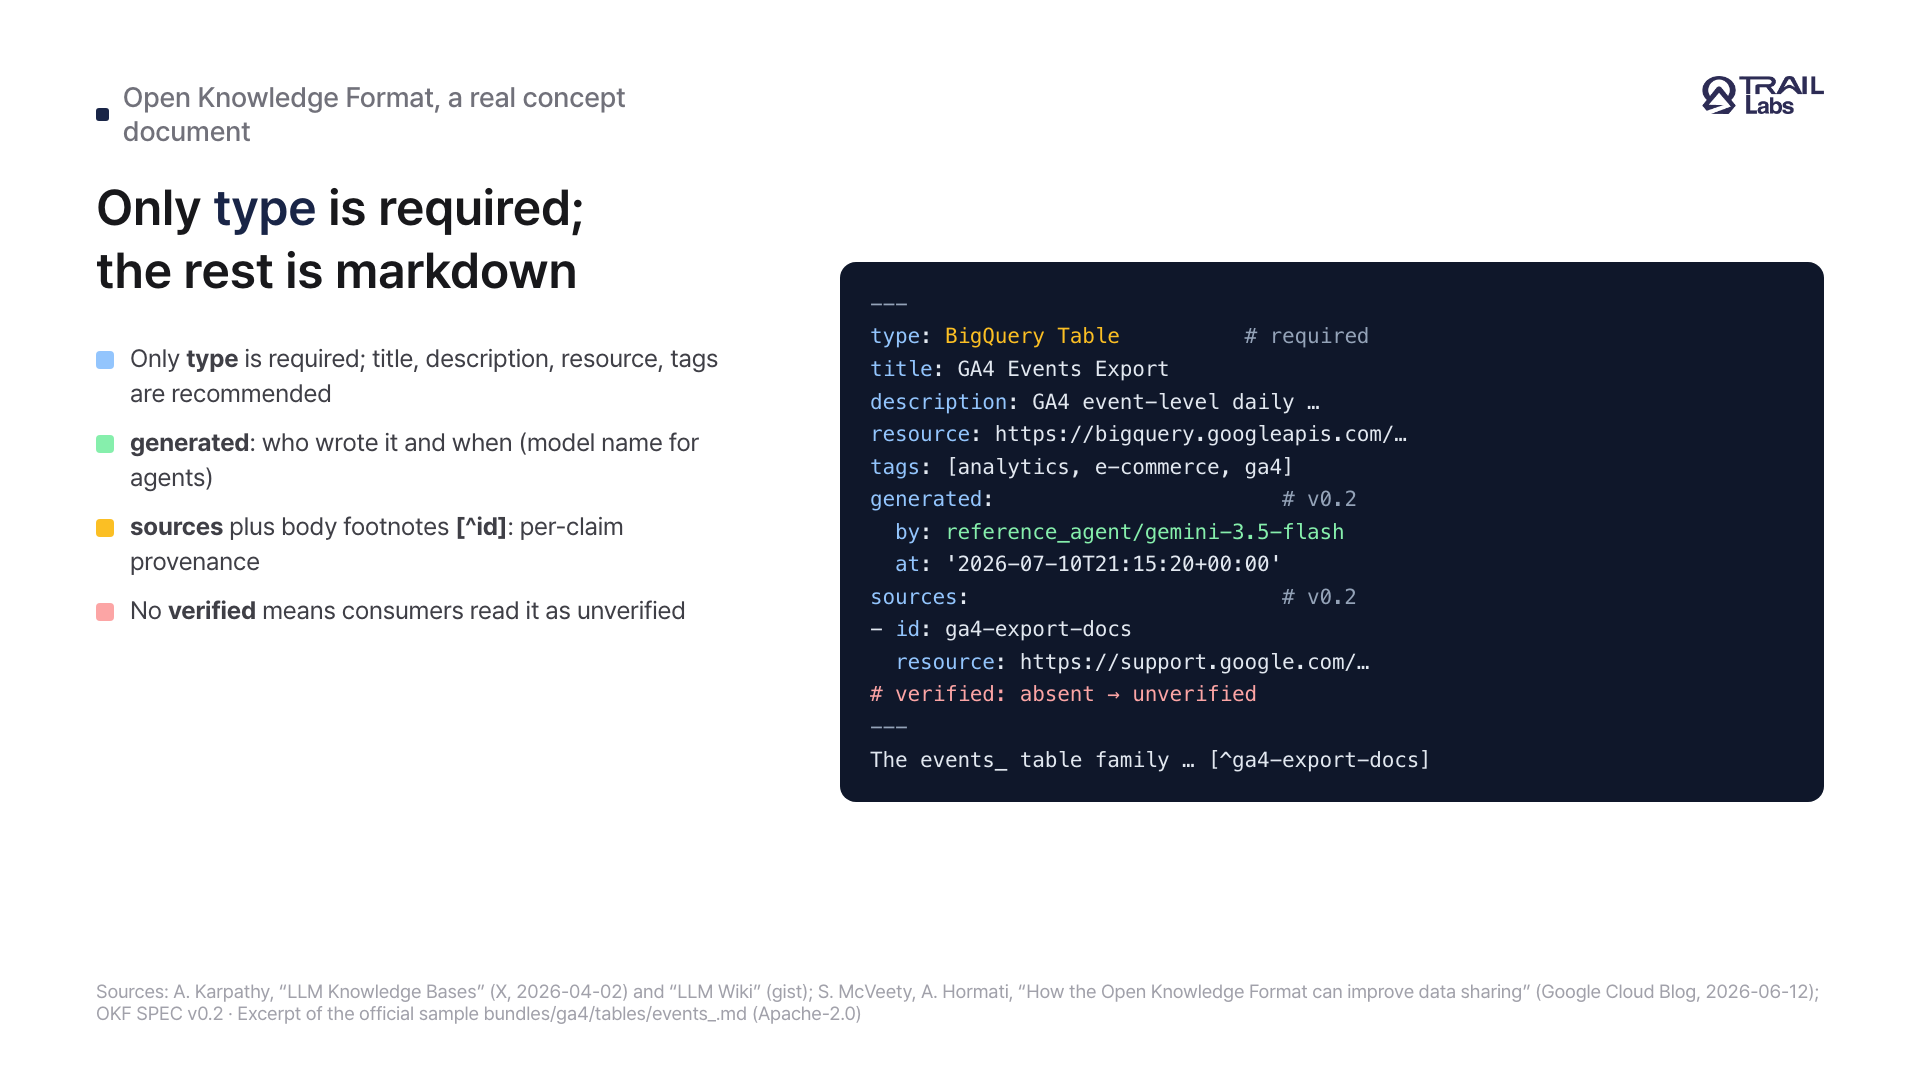
그림 2. OKF 공식 GA4 sample의 concept 문서 하나. type만 필수이고, provenance는 frontmatter의 sources와 본문 footnote로 이어진다 [4][5].
agent가 쓴 문서를 어떻게 믿나
v0.2가 단단하다고 느낀 건 출발점이다. bundle을 agent가 계속 고쳐 쓰는 대상으로 본다 [4]. specification은 concept 대부분이 machine-generated라면 consumer에게 다섯 가지 답이 필요하다고 적는다. 무엇에서 만들었나(provenance), 얼마나 믿을 만한가(trust), 아직 사실인가(freshness), 현재 버전인가(lifecycle), 숫자가 정해진 방식대로 계산됐나(attestation) [4]. repository의 specification 기록상 v0.2로 넘어간 건 2026년 7월 24일이다 [4].
provenance는 sources 목록에 담고, 문장 단위 provenance는 본문 footnote label을 sources의 id와 맞춰 연결한다 [4]. 위치 번호 대신 stable id를 쓰는 이유가 실무적이다. agent가 문서를 계속 고쳐 쓰다 보면 목록 순서가 바뀌고, 위치로 연결한 출처는 아무 오류 없이 엉뚱한 문장에 붙는다 [4]. LLM에게 문서를 고치게 할 때 번호식 [1], [2] 참조가 조용히 밀리는 문제를 형식 차원에서 막는 선택이다. source마다 author, 사용 횟수, 마지막 수정 시각을 적을 수 있지만 credibility score는 저장하지 않는다. score는 주관적이고 consumer마다 다르고 금방 낡는다는 이유다 [4].
trust는 쓴 쪽과 확인한 쪽을 분리한다. generated는 누가 언제 썼는지, verified는 누가 언제 확인했는지이고, 사람이 확인했다면 id를 human:으로 시작해야 한다 [4]. consumer는 verified가 없으면 unverified, process나 agent만 확인했으면 machine-confirmed, 사람이 확인했으면 human-reviewed로 읽는다 [4]. status는 draft·stable·deprecated 중 하나이고, stale_after는 그 시각이 지나면 낡은 내용으로 보라는 절대 시각이다 [4]. 이 field가 없다고 문서를 reject해서는 안 되고, 등급은 access control이 아니라 advisory signal이다 [4].
공식 sample bundle을 세어 보면, format이 자리를 만드는 것과 그 자리가 채워지는 것은 별개였다. Google reference agent가 GA4, Stack Overflow, Bitcoin 공개 데이터로 만든 bundle 3개의 concept 문서 44개는 모두 generated와 sources가 있었고, verified가 있는 문서는 하나도 없었다 [5]. spec대로 읽으면 44개 전부 unverified다. verification 기록이 채워진 쪽은 가상의 소매 회사를 예시로 만든 acme_retail bundle로, concept 문서 9개 중 8개에 사람 verifier가, 7개에 expiry가 적혀 있었다 [5]. reference agent가 공개 데이터로 만든 쪽은 provenance까지만 채웠고, verification은 예시용으로 따로 만든 bundle에만 채워져 있었던 셈이다.
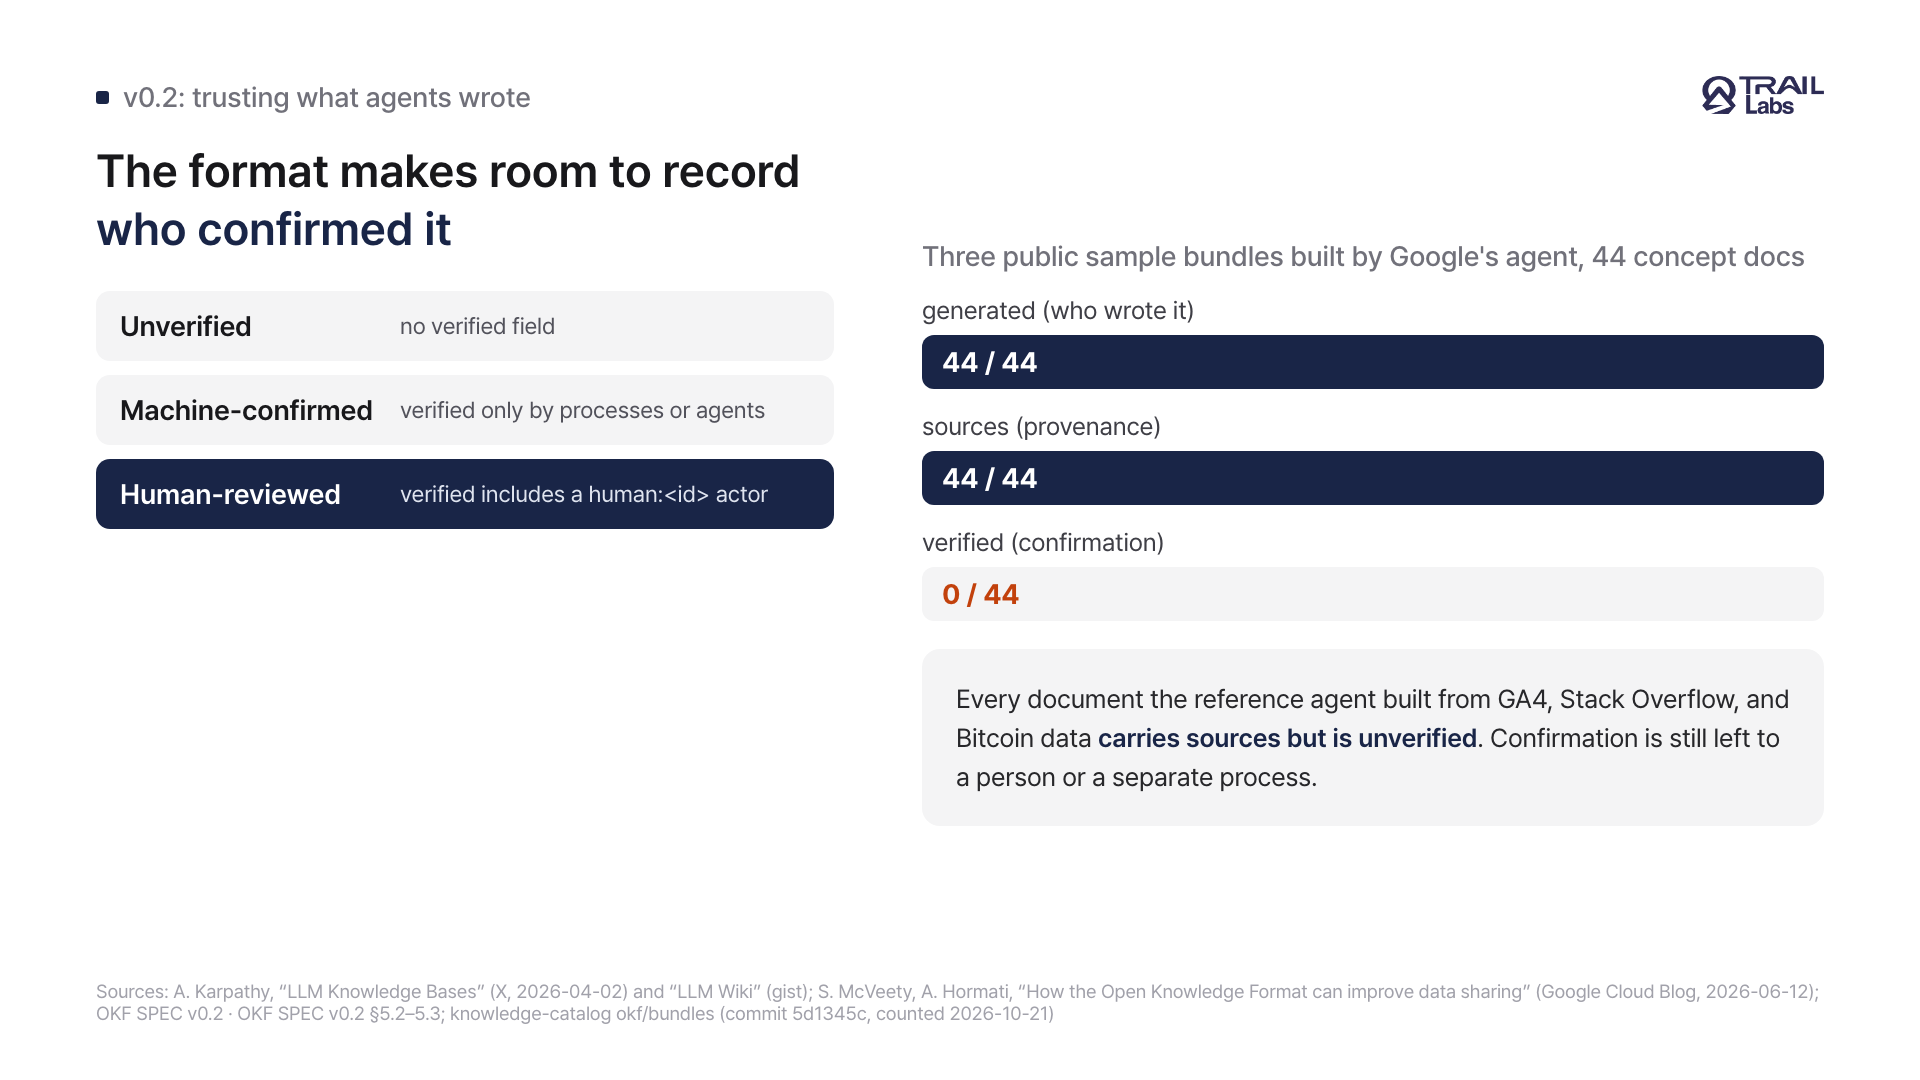
그림 3. Google agent가 만든 공개 sample 문서 44개는 모두 author와 source를 적었고, verification 기록은 하나도 없었다 [4][5].
내가 agent용 knowledge base를 짠다면
사람이 아무 editor로나 열어 읽고 agent가 별도 tool 없이 parse하는 형식, 즉 frontmatter가 달린 markdown directory가 지금 두 흐름이 만나는 자리다 [1][4]. 처음부터 spec 전체를 따를 필요는 없다. OKF가 요구하는 건 type 하나뿐이고, field가 빠지거나 link가 깨진 bundle도 reject하지 말라고 규정한다 [4]. 내가 처음부터 짠다면 이 순서로 시작하겠다.
- concept 하나를 파일 하나로 두고, frontmatter에 type과 한 줄 description을 적는다 [4].
- 폴더마다 index.md에 문서 목록과 한 줄 설명을 두고, log.md에 날짜별 변경을 남긴다. Karpathy는 log 항목을 같은 prefix로 시작하면 grep 한 줄로 최근 기록을 뽑을 수 있다고 적었다 [2].
- agent가 쓴 문서에는 generated에 model 이름을 적고, 근거 문장은 footnote로 sources id에 연결한다 [4].
- 사람이 확인한 문서에만 verified를 달고, 숫자처럼 빨리 낡는 내용에는 stale_after를 건다 [4].
- wiki의 구조와 workflow는 CLAUDE.md나 AGENTS.md 같은 schema 파일에 적는다. OKF는 이 부분을 규정하지 않는다 [2][4].
여기에 내 판단을 두 가지 더한다. 첫째, verified는 field를 만드는 것만으로 채워지지 않는다. Google sample이 보여주듯 agent가 자동으로 만든 문서에는 provenance까지만 남는다. 그래서 나라면 human verification을 문서 전체가 아니라 숫자처럼 틀리면 비용이 큰 문서에만 요구하고, 그 문서를 외부로 내보내기 전에 verified와 stale_after를 검사하는 lint를 따로 둘 것이다. spec이 lint 절차를 producer 몫으로 남겨두었으니 이건 직접 짜야 한다. 둘째, footnote는 처음부터 stable id로 건다. 나중에 위치 번호에서 id로 옮기는 건, agent가 이미 수십 번 고쳐 쓴 문서에서 어느 출처가 어느 문장에 붙어 있었는지를 거꾸로 복원하는 일이 되기 때문이다.
한계와 아직 모르는 것
OKF는 v0.x specification이고, Google 밖에서 얼마나 채택됐는지는 확인하지 못했다. Google blog와 spec 모두 OKF를 썼을 때 agent 답변 정확도가 얼마나 달라지는지 측정을 내놓지 않았다 [3][4]. 이 spec이 약속하는 건 형식이 맞으면 도구끼리 서로 읽을 수 있다는 것까지다.
Karpathy의 관찰은 한 사람의 연구 wiki, 약 100편 규모에서 나왔다 [1]. 그는 wiki가 커지면 제대로 된 search가 필요해진다고 적었고, 자기 wiki 위에 작은 search engine을 직접 만들어 쓰고 있다고 했다 [1][2]. 같은 방식이 문서 수천, 수만 개 규모의 조직 wiki에서도 RAG 없이 통하는지는 공개된 근거가 없다.
sample 집계는 2026년 10월 21일 공식 repository 기준이고, reference agent가 만든 공개 예시만 센 것이다 [5]. Google 내부나 다른 조직의 실제 운영 bundle에서 verification 기록이 얼마나 채워지는지는 알 수 없다. trust 등급은 누군가 확인했다는 기록일 뿐 내용이 맞다는 보장은 아니고, spec도 이를 advisory signal이라고 부른다 [4].
References
- Andrej Karpathy, “LLM Knowledge Bases”, X post, 2026-04-02
- Andrej Karpathy, “LLM Wiki”, GitHub gist, 2026
- Sam McVeety, Amir Hormati, “How the Open Knowledge Format can improve data sharing”, Google Cloud Blog, 2026-06-12
- Open Knowledge Format Specification v0.2, GoogleCloudPlatform/knowledge-catalog (Apache-2.0)
- OKF sample bundles (acme_retail, crypto_bitcoin, ga4, stackoverflow), GoogleCloudPlatform/knowledge-catalog okf/bundles