채널 ROI를 숫자 하나로 보고하면, 데이터가 그 숫자를 실제로 뒷받침하는지가 가려진다. marketing mix model(MMM)은 채널별 광고 집행과 매출 이력을 함께 놓고 각 채널의 매출 기여를 추정하는 통계 모델이다. 추정하려는 값은 직접 관측되지 않고 과거 이력에서 추론된다. 그러니 정직한 출력은 값 하나라기보다 “그 값이 어디쯤일지에 대한 belief의 분포”에 가깝다. Bayesian MMM은 정확히 그 분포를 돌려주고, 거기서 나오는 credible interval의 폭이 예산 결정에 필요한 핵심 정보가 된다.
모델 출력이 점 하나로 나오면 사람은 그 점을 믿는다. 엔지니어로 일하면서 가장 자주 본 실패가 이것이었다. 모델이 모른다고 말할 방법이 없으면, 모르는 상태가 숫자 하나에 덮여 의사결정까지 흘러간다. MMM은 이 문제가 가장 노골적으로 드러나는 영역이라 Bayesian 접근이 어떻게 그걸 다루는지 따로 정리해 두고 싶었다. 모델 구조와 수식은 Google이 공개한 open-source MMM framework인 Meridian 공식 문서와 GitHub repository, 그리고 그 바탕이 된 Google Research 논문에서 확인했고 [1][5][6], 2026년 10월 기준으로 공개 문서를 다시 열어 대조했다. 이 글의 수식은 MMM의 표준 정의이고 특정 구현의 functional form·prior·추정치를 주장하지 않는다. 어떤 방법도 광고 성과를 보장하지 않는다는 점도 같이 적어 둔다.
MMM은 채널별 기여를 과거 이력에서 추정한다
MMM은 기간별 매출을 광고 채널의 효과, 광고 외 요인, 설명되지 않는 noise로 나눈다. 가장 단순한 형태는 이렇다.
\[y_t = \beta_0 + \sum_{c} f_c(x_{c,t}) + \gamma^\top z_t + \varepsilon_t\]$y_t$는 기간 $t$의 성과(매출 같은 KPI), $x_{c,t}$는 그 기간 채널 $c$의 집행액이다. $f_c$는 채널마다 다른 response function으로, 앞선 집행의 효과가 이어지는 carryover와 집행이 늘수록 효율이 떨어지는 saturation을 담는다. $z_t$는 가격·계절성·프로모션처럼 반드시 넣어야 하는 control variable이다. 이게 빠지면 그 효과가 채널 항으로 새어 들어가서, 원래 계절 덕이던 매출을 광고 덕으로 읽게 된다. 통계 모델링에서 omitted variable bias라고 부르는 바로 그 문제다.
Meridian model specification은 이 구조를 geo 단위로 확장한다. 표준 Meridian 모델은 “a geo-level hierarchical model with non-linear parametric transformations on the media variables”다 [2]. 지역마다 계수가 조금씩 다를 수 있게 두되 지역들이 정보를 공유하도록 묶는 hierarchical 구조다. repository README는 geo 단위 데이터가 있으면 쓰기를 권하고 national 단위 모델도 지원한다고 설명한다 [5]. Meridian이 cookie나 user 단위 정보를 쓰지 않고 aggregated data로 동작한다는 점도 README에 적혀 있다.
광고 효과는 이월되고 포화된다: adstock과 Hill function
response function $f_c$는 보통 두 단계로 만든다. Meridian의 기본 설정은 먼저 carryover(adstock)를 적용하고 그 결과에 saturation(Hill) function을 씌우는 순서다 [2].
\[\mathrm{Hill}(q;\,ec,\,slope) = \frac{1}{1 + (q/ec)^{-slope}}\]adstock은 이번 주 매출에 지난 몇 주의 집행이 decay weight를 달고 같이 들어오게 만드는 단계다. Meridian은 maximum lag $L$ 안의 집행을 decay parameter $\alpha$로 weighted average한다 [2]. Hill function은 집행이 늘수록 반응이 S자 또는 concave 곡선으로 꺾이게 만든다. $ec$는 효과가 절반에 이르는 지점, $slope$는 곡선이 꺾이는 가파름을 정한다. 두 함수의 순서를 바꾸는 옵션도 문서에 있다.
이 구조를 처음 체계적으로 정리한 Google의 2017년 논문은 광고에 lag effect와 diminishing return이 있어서 linear regression으로는 잡기 어렵다는 문제에서 출발했다 [6]. 그래서 carryover와 shape을 유연한 함수로 두고, 이전 모델이나 관련 모델의 지식을 prior로 넣는 Bayesian 추정을 제안했다. 같은 논문은 posterior sample에서 ROAS와 marginal ROAS(mROAS) 같은 attribution metric을 계산하는 방법도 보여준다.
여기서 눈여겨볼 점은 parameter 수다. 채널 하나마다 회귀 계수 외에 $\alpha$, $ec$, $slope$가 붙는다. 비선형 parameter가 채널 수에 비례해서 늘어나는 구조이고, 이게 뒤에서 데이터 양 문제로 그대로 돌아온다.
Bayesian MMM은 숫자 하나 대신 분포를 돌려준다
위 식의 parameter는 하나도 직접 관측되지 않는다. 전부 이력에서 추론한 값이다. Bayesian 추정은 이 사실을 계산에 그대로 담는다. 데이터를 보기 전의 belief(prior)에 데이터의 증거(likelihood)를 곱해 데이터를 본 뒤의 belief(posterior)를 얻는다.
\[p(\beta \mid D) \propto p(D \mid \beta)\, p(\beta)\]$D$는 관측한 집행·매출 이력이고, $p(\beta)$는 데이터를 보기 전에 받아들이기로 한 가정이다. Meridian 소개 문서는 모델의 주요 출력이 “a posterior distribution of model parameters”이고, 여기서 ROI 추정치·credible interval·response curve 같은 비즈니스 지표를 낸다고 설명한다 [1].
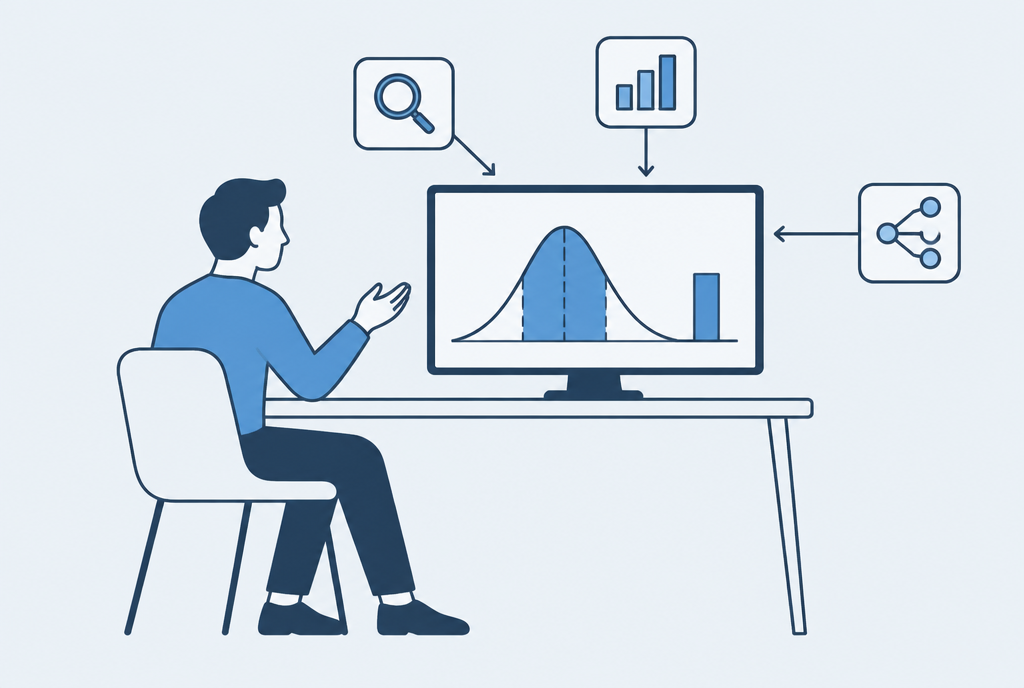
그림 1. 종 모양 분포의 가운데 구간(음영)과 막대 하나를 한 화면에 나란히 놓은 개념 삽화. 실제 데이터를 담은 차트는 아니다.
숫자 하나 대신 분포를 받으면 point estimate로는 할 수 없는 말을 할 수 있다.
\[P(\mathrm{ROI}_c \in [a, b] \mid D) = 0.9\]“관측한 데이터와 prior 가정 아래에서 채널 $c$의 ROI가 $a$와 $b$ 사이에 있을 확률이 90%”라는 뜻이다. 이게 90% credible interval이다. frequentist confidence interval과 달리, 주어진 데이터 아래에서 값 자체에 대한 확률로 바로 읽힌다. confidence interval을 “참값이 이 안에 있을 확률 95%”로 잘못 읽는 경우가 흔한데, credible interval은 애초에 그 해석이 맞는 구간이라 보고서에 옮겨 적기 편하다. Meridian도 ROI 추정치를 이런 credible interval과 함께 낸다 [1].
credible interval의 폭이 곧 결과다
구간이 얼마나 넓은지가 그 자체로 하나의 결과다. 어떤 채널의 90% 구간이 0.8배에서 4.1배까지 걸쳐 있다고 해 보자(설명용 가상 예시이고 실제 데이터가 아니다. 이런 구간 자체는 Meridian의 기본 출력이다 [1]). 이 채널은 4.1배 채널도 0.8배 채널도 아니다. 지금 데이터로는 아직 구분할 수 없는 채널이다. 이걸 중앙값 하나로 보고하고 그 숫자에 맞춰 예산을 옮기면, 아무도 보여주지 않은 동전 던지기에 결정을 맡기는 셈이다.
| 구간 모양 | 데이터가 말하는 것 | 예산 결정에서의 의미 |
|---|---|---|
| 좁고 1배보다 확실히 위 | 이 데이터로 효과가 분명히 구분된다 | 증액 후보로 검토할 근거가 있다 |
| 좁고 1배 근처 또는 아래 | 이 데이터로 효과가 작다는 게 구분된다 | 축소를 검토할 근거가 있다 |
| 넓고 1배를 가로지름 | 아직 효과를 구분하지 못했다 | 재배분보다 실험이 먼저다 |
표 1. 채널 ROI credible interval의 모양별 해석. 폭과 위치를 함께 봐야 한다. 기준선 1배는 집행액만큼 매출이 돌아오는 지점이고, Meridian prior 문서도 ROI 1.0을 수익성 판단 기준으로 든다 [3].
원 논문도 같은 방향을 가리킨다. Google의 2017년 논문은 실제 샴푸 광고 데이터에 모델을 적용한 뒤, 모델이 제시하는 optimal media mix 자체가 “has a large variance due to the variance of the parameter estimates”라고 적었다 [6]. 최적 배분조차 점이 아니라 분포라는 뜻이다. 통계적으로 당연한 얘기다. optimizer는 posterior의 함수이니 parameter uncertainty가 그대로 전파된다. 그래서 실행할 만한 출력은 채널 순위표보다, uncertainty 범위 전체에서 살아남는 배분과 중앙값에서만 좋아 보이는 배분을 구분한 결과다.
측정하지 못한 것과 0은 다른 사실이다
point estimate는 구조적으로 이 구분을 지운다. 증거가 숫자 하나를 뒷받침하지 못할 때도 언제나 숫자 하나를 돌려주기 때문이다. 데이터 시스템에서 null과 0을 같은 칸에 넣으면 생기는 사고와 같은 종류다. 센서가 0을 읽은 것과 센서 신호가 끊긴 것을 같은 값으로 처리하면 그 뒤의 모든 로직이 거짓 위에서 돈다. 측정하지 못한 칸과 0이 나온 칸을 섞으면 리포트는 사실과 다른 이야기를 한다.
광고 채널도 마찬가지다. 앞의 가상 예시로 보면 “ROI 1.9배”와 “ROI 0.8–4.1배, 아직 구분 불가”는 같은 중앙값에서 나올 수 있지만 서로 다른 사실이다. 앞 문장은 확신을, 뒤 문장은 데이터의 한계를 전한다. Meridian도 posterior에서 ROI 추정치와 credible interval을 함께 낸다 [1]. 대시보드에 채널 성과를 구간 없이 띄우면, 구간이 넓은 채널과 좁은 채널이 같은 무게로 보인다. 정보가 계산은 됐는데 화면에서 사라지는 것이다.
데이터가 부족하면 구간은 넓게 남고 prior의 무게가 커진다
이런 모델은 채널을 서로 떼어낼 만큼 충분한 집행·매출 이력이 있어야 한다. Meridian 데이터 요구량 문서는 parameter 하나당 여러 개의 data point를 확보하라고 권한다 [4]. 문서의 예시는 national 모델에서 2년치 weekly 데이터(104개)에 parameter 26개면 parameter당 4개라서 “too low to estimate the model reliably”라는 것이다. 대안으로 채널 합치기, 시간 효과의 knot 수 줄이기, confounder가 아닌 control variable 빼기, 3년 이상의 weekly 데이터로 늘리기를 든다. 같은 문서는 MMM이 채널 단위에서 잘 작동하는 거시 도구라서 캠페인 단위로 돌리는 건 권하지 않는다고 적는다.
| 데이터 조건 | posterior에 생기는 일 | 대응 |
|---|---|---|
| 이력이 짧음 | 구간이 넓게 남는다 | 기간을 늘리거나 parameter를 줄인다 |
| 채널끼리 함께 움직임(collinearity) | 채널별 기여를 떼어내지 못한다 | 채널을 묶거나 실험으로 분리한다 |
| 데이터가 약함 | prior의 영향이 커진다 | prior의 근거를 문서로 남긴다 |
표 2. 데이터 조건별로 Bayesian MMM 결과가 달라지는 방식. Meridian 문서와 Google 2017년 논문을 내가 정리했다 [4][6].
parameter당 4개라는 숫자는 앞에서 본 구조를 떠올리면 실감이 난다. 채널마다 비선형 parameter가 서너 개씩 붙으니, 채널 몇 개만 넣어도 104주 데이터로는 금방 바닥난다. 여기에 collinearity까지 겹치면, 예를 들어 두 채널이 매번 같은 시즌에 같이 켜지고 같이 꺼진다면, likelihood는 두 채널의 합만 알려주고 나눠 갖는 비율은 거의 알려주지 않는다. 그 비율을 정하는 건 결국 prior다.
짧거나 collinear한 이력에서 posterior가 넓게 남는 건 모델이 고장 났다는 뜻이 아니다. 모델이 정직하게 “모르겠다”고 말하는 것이다. 2017년 논문의 simulation도 데이터가 클 때는 추정이 잘 되지만 표본이 작을 때는 prior가 결과에 크게 영향을 준다고 보고했다 [6]. 그래서 prior는 기술적 세부가 아니라 결과와 함께 설명하고 방어해야 하는 입력이다. Meridian prior 문서도 기본 prior가 “moderately informative”이고, prior의 standard deviation이 처음 belief와 데이터의 증거 사이에 무게를 어떻게 나눌지 정한다고 설명한다 [3].
구간을 좁히는 방법은 실험이다
상관관계로 이뤄진 이력은 모델이 잘 맞았다고 해서 인과로 바뀌지 않는다. 구간을 좁히는 길은 모델을 더 맞추는 게 아니라 실험이다. Meridian 문서는 incrementality experiment(광고를 켠 집단과 끈 집단을 비교해 순수한 추가 효과를 재는 실험)가 prior를 세우는 가장 강한 근거일 수 있다고 쓰면서도, 실험 결과를 prior로 옮기는 일은 정확한 공식으로 떨어지지 않는다고 덧붙인다 [3]. 실험은 특정 기간·지역·캠페인 설정에 묶여 있고 비교 baseline도 MMM과 다를 수 있어서, 두 숫자가 재는 대상(estimand)이 처음부터 같지 않을 때가 많다.
이 문제의식은 Meridian 이전부터 있었다. Google의 Chan과 Perry의 2017년 논문은 MMM이 미디어 효과에 대해 일관되게 타당한 답을 내는 데 부딪히는 어려움과 더 나은 inference를 위한 방향을 정리했다 [7]. 순서로 옮기면 이렇다. 모델로 채널별 구간을 먼저 보고, 구간이 넓고 예산 비중이 큰 채널부터 실험으로 확인하고, 그 결과를 prior로 반영해 다시 추정한다. 이 loop가 구간을 좁혀 가는 방법이다.
내가 MMM을 붙인다면
여기부터는 내 판단이다. 모델을 production에 올리는 입장에서 MMM을 다룬다면 세 가지를 지키겠다.
첫째, 출력 스키마에서 point estimate만 내보내는 경로를 없앤다. ROI는 항상 중앙값과 interval 양 끝을 한 묶음으로 내보내고, interval이 1배를 가로지르는 채널에는 “구분 불가” 상태를 별도 값으로 붙인다. 화면에서 구간이 사라지는 건 대개 모델 문제가 아니라 데이터 파이프라인 끝단에서 숫자 하나만 골라 쓰기 때문이다.
둘째, prior sensitivity를 결과의 일부로 남긴다. 같은 데이터에 prior의 standard deviation만 바꿔 다시 돌려보고, 채널 순위나 interval이 얼마나 움직이는지를 같이 기록한다. 데이터가 약한 채널일수록 많이 움직일 것이고, 그 움직임 자체가 “이 채널은 prior가 결정하고 있다”는 진단이다.
셋째, fit 지표를 인과의 증거로 쓰지 않는다. control variable 하나를 빼먹으면 그 효과가 채널 항으로 새는데, 이 오류는 in-sample fit을 오히려 좋게 만들 수도 있다. 모델이 잘 맞는지는 holdout으로 보고, 채널 효과가 맞는지는 실험으로 본다. 둘은 다른 질문이다.
이 글의 한계
- MMM은 광고·매출 이력이 충분할 때 유효하다. 집행 이력이 짧거나 채널 수에 비해 데이터가 적으면 구간이 넓게 남고, 그 상태에서 내린 재배분은 데이터의 지지를 받지 못한다.
- prior는 결과를 바꾼다. 같은 데이터라도 prior 가정에 따라 posterior가 달라지고, 데이터가 약할수록 차이가 크다. prior의 근거를 결과와 함께 공개해야 하는 이유다.
- fit이 인과를 증명하지 않는다. control variable을 빠뜨리면 그 효과가 채널 항으로 흘러가고, 이 오류는 fit 지표로 드러나지 않을 때가 많다.
- 채널 단위 도구다. Meridian 문서도 캠페인 단위 분석을 권하지 않는다 [4]. 소재·캠페인 수준의 판단에는 다른 근거가 필요하다.
- 특정 구현을 평가하지 않았다. 수식은 공개 문서의 표준 정의이고, 예시 구간(0.8–4.1배)은 설명용 가상 값이다. 실제 브랜드의 채널 ROI가 아니고, 나는 Meridian을 이 글을 위해 직접 돌려보지 않았다.
채널 ROI를 숫자 하나 대신 구간으로 받으면, 데이터가 무엇을 구분했고 무엇을 아직 구분하지 못했는지가 같이 보인다. 방어할 수 없는 확신에 찬 숫자보다는, 가정을 붙인 넓은 구간이 다음 실험을 고르는 데 더 쓸모 있다.
References
- Google, “An introduction to Meridian”, Meridian documentation
- Google, “Model specification”, Meridian documentation
- Google, “Calibrate treatment priors”, Meridian documentation
- Google, “Amount of data needed”, Meridian documentation
- google/meridian, GitHub repository README
- Jin, Wang, Sun, Chan & Koehler, “Bayesian Methods for Media Mix Modeling with Carryover and Shape Effects”, Google Research (2017)
- Chan & Perry, “Challenges and Opportunities in Media Mix Modeling”, Google Research (2017)