LLM 활용의 마지막 단계는 모델을 빌리지 않고 직접 갖는 것이다. 여기까지는 전부 빌려 쓰는 이야기였다. 채팅창에 prompt를 넣었고, 모델에게 코드를 맡겼고, loop를 agent에게 넘겼고, 그 주변에 harness를 짰다. 그동안 모델 자체는 늘 남의 API 뒤에 있었다.
“LLM 활용의 진화” 시리즈 ⑤편(마지막). ① Prompting · ② Vibe coding · ③ Agents · ④ Harness engineering · ⑤ Open models.
이 편을 따로 길게 쓰고 싶었던 건 내 출발점 때문이다. 대학원에서 object detection·segmentation 모델을 압축하고, 연산 예산이 빠듯한 하드웨어에서 inference를 돌리는 연구를 했다. startup CTO로 일할 때는 on-device AI를 제품에 넣었다. 그때는 모델을 손에 쥐고 줄이고 고치는 게 당연한 일이었다. LLM으로 넘어오면서 그 감각이 API 호출 한 줄로 바뀌었다. 편해진 만큼 내려놓은 것도 있고, open-weight 모델은 그걸 다시 가져오는 선택지다.
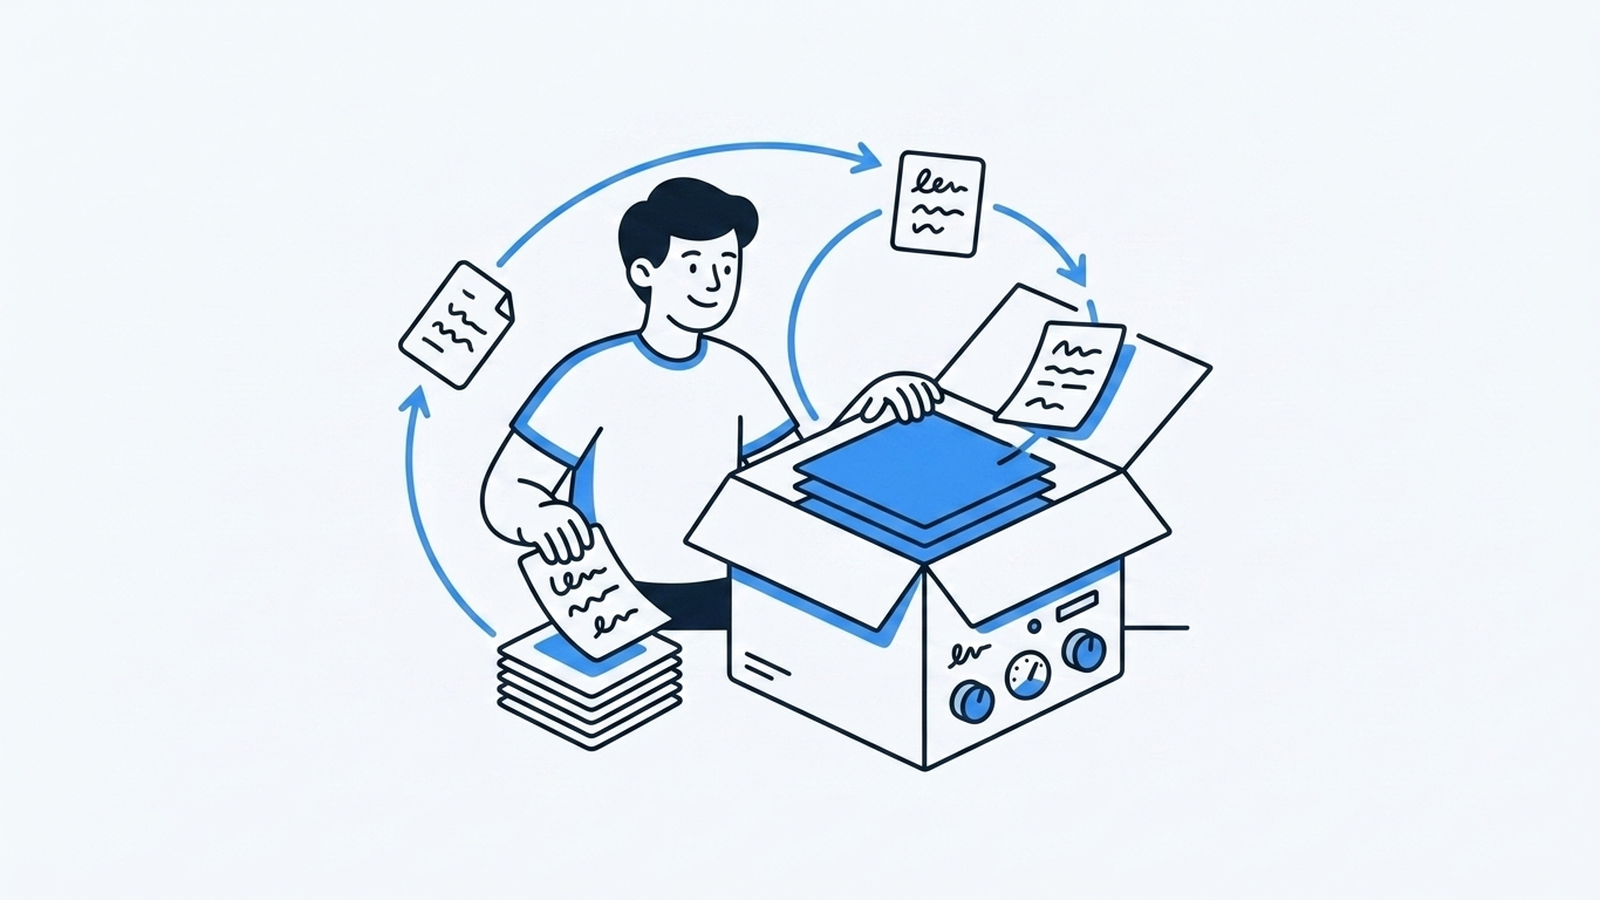
그림 1. 모델을 빌리는 단계에서 모델·harness·데이터를 함께 소유하는 단계로.
왜 모델을 소유하나
frontier 모델을 API로 쓰는 건 편하다. 대신 세 가지를 내준다. 가격이나 이용 정책이 바뀌면 그대로 따라가야 하고, 데이터를 밖으로 보내야 하고, 모델을 내 domain에 맞게 고칠 수 없다. open-weight 모델은 이 셋을 반대로 뒤집는다.
| 구분 | 비용 통제 | 데이터 프라이버시 | domain customization |
|---|---|---|---|
| frontier API | 가격·정책 변경을 따라감 | 데이터를 외부로 전송 | prompt·RAG 수준까지 |
| open-weight 모델 (예: Hermes) | 인프라 비용만 직접 관리 | 자체 인프라 안에서 처리 | 직접 fine-tuning 가능 |
표에 안 보이는 비용도 있다. “인프라 비용만 직접 관리”는 뒤집어 말하면 GPU 확보, serving, 모니터링, 장애 대응을 전부 내가 진다는 뜻이다. lab에서 한 번 돌아가는 모델과 매일 돌아가는 모델 사이의 간극을 API 회사가 대신 메워주던 걸, open-weight로 오면 고스란히 내가 메워야 한다. 소유는 통제권과 함께 운영 책임을 같이 가져오는 일이다.
대표적인 예가 Nous Research의 Hermes 계열이다. 가장 최근 버전인 Hermes 4.3(2025년 12월, ByteDance의 Seed-OSS-36B 기반)까지 오면서, system prompt를 잘 따르고 steering과 function calling에 강한 open 모델로 자리를 잡았다 [1][3]. 내가 눈여겨본 건 Nous가 모델만 내놓지 않는다는 점이다. open agent framework인 Hermes Agent와 native desktop app인 Hermes Desktop(2026년 공개, MIT)까지 같이 연다. 모델, agent, harness를 한 벌로 가져갈 수 있다.
function calling에도 표준이 있다
1편에서 다룬 structured output(tool_use)과 같은 장치가 open 모델에도 있다. Hermes Function Calling 형식 [2]은 tool 정의(JSON schema)를 <tools>에, 호출을 <tool_call>에, 결과를 <tool_response>에 담는다.
<!-- Hermes function calling: tool 정의는 JSON schema로 <tools> 안에 -->
<tools>
[{"name": "emit_slides",
  "parameters": {"type": "object",
    "properties": {"slides": {"type": "array"}},
    "required": ["slides"]}}]
</tools>

<!-- 모델은 이 형식으로 호출한다 -->
<tool_call>
{"name": "emit_slides", "arguments": {"slides": [/* … */]}}
</tool_call>
형식만 다르고 발상은 1편의 tool_use와 같다. 출력을 interface로 강제한다. 그래서 frontier 모델 기준으로 짠 harness를 open 모델로 옮겨도 대부분 그대로 쓴다. 바뀌는 건 XML tag를 parse해서 기존 JSON 구조로 바꿔주는 adapter 한 층이다.
내가 이 adapter를 짠다면 형식 변환보다 parse 실패를 받아내는 경로를 먼저 만든다. tag가 안 닫히거나 arguments JSON이 깨진 출력이 오면 schema 검증에서 걸러 retry하고, 그 실패율을 모델별로 기록해 둔다. API 모델에서는 provider가 이 부분을 상당히 정리해서 넘겨주지만, 직접 serving하는 모델에서는 그 몫도 내 코드로 넘어온다.
harness는 데이터 공장이다
4편에서 말한 harness의 부수 효과가 여기서 쓸모를 얻는다. 잘 짠 harness는 실행할 때마다 규격이 맞는 기록을 남긴다. 입력, tool call, 검증을 통과한 출력. 이 세 칸이 그대로 instruction-tuning dataset의 한 행이다.
그러면 flywheel이 돈다. harness를 많이 돌릴수록 domain 데이터가 쌓인다. 그 데이터로 Hermes 같은 open 모델을 domain에 맞게 fine-tuning한다. 기존 workflow는 그대로 eval 기준이 된다. 더 잘 맞는 모델이 다시 harness를 돈다. 그래서 나는 harness를 처음 짤 때부터 로그를 학습 데이터 형식으로 남기는 쪽을 택한다. tool_use로 받은 structured output과, 생성에 쓰지 않은 별도 judge의 판정을 같은 행에 묶어 두면 나중에 따로 정제할 일이 크게 줄어든다.
경량화를 해본 입장에서 하나 더 보이는 게 있다. domain이 좁혀지면 frontier 모델이 하는 일 전부가 필요하지 않다. 필요한 일만 잘하는 더 작은 모델로 distillation하거나 quantization해서, 더 싼 하드웨어나 경우에 따라 device 위에서 돌릴 여지가 생긴다. API 모델로는 이 선택지가 아예 없다. 모델 압축 연구를 하던 시절의 질문이 LLM에서도 그대로 다시 열리는 셈이다.
솔직히 이 단계는 아직 가설에 가깝다. 데이터가 충분해야 하고, 품질 관리가 돼야 하고, 투자가 꾸준히 이어져야 한다. 설계상 걸리는 점도 있다. 검증을 통과한 출력만 모으면 모델이 이미 잘하던 입력 위주로 데이터가 쌓일 수 있다. 실패한 실행을 어떻게 고쳐서 데이터에 넣을지까지 정해야 flywheel이 제자리에서만 돌지 않는다. 그래도 방향은 분명하다. 모델을 빌리는 데서, 모델·harness·데이터를 함께 소유하는 쪽이다.
다섯 편을 마치며
다섯 단계를 지나왔다. 채팅창에 prompt를 치고, vibe로 만들고, loop를 agent에 넘기고, 그 주변에 harness를 짜고, 마지막에 모델 층까지 손에 넣는 데까지. LLM 활용은 개인의 감각에서, 팀이 설계하고 소유하는 시스템 쪽으로 옮겨가고 있다.
control engineer로 일을 시작하면서 배운 기준으로 보면 자연스러운 흐름이다. 시스템은 한 번 돌아갈 때가 아니라 매일 돌아갈 때 의미가 있고, 매일 돌리려면 손댈 수 있는 층이 많아야 한다. 모델은 그 층들 가운데 가장 마지막까지 남의 손에 있던 층이다.