prompt는 모델에게 거는 주문이 아니라, 모델이 받을 context를 설계하는 일이다. LLM을 처음 쓸 때는 다들 비슷하게 시작한다. 채팅창을 열고 원하는 걸 문장으로 적는다. 그런데 같은 모델, 같은 화면을 쓰는데도 결과물은 사람마다 꽤 다르다. 그 차이가 처음 벌어지는 자리가 prompt다.
‘LLM 활용의 진화’ 시리즈 ①편. ① Prompting · ② Vibe coding · ③ Agents · ④ Harness engineering · ⑤ Open models. 사람이 LLM을 다루는 방식이 어떻게 바뀌어 왔는지 단계별로 따라간다.
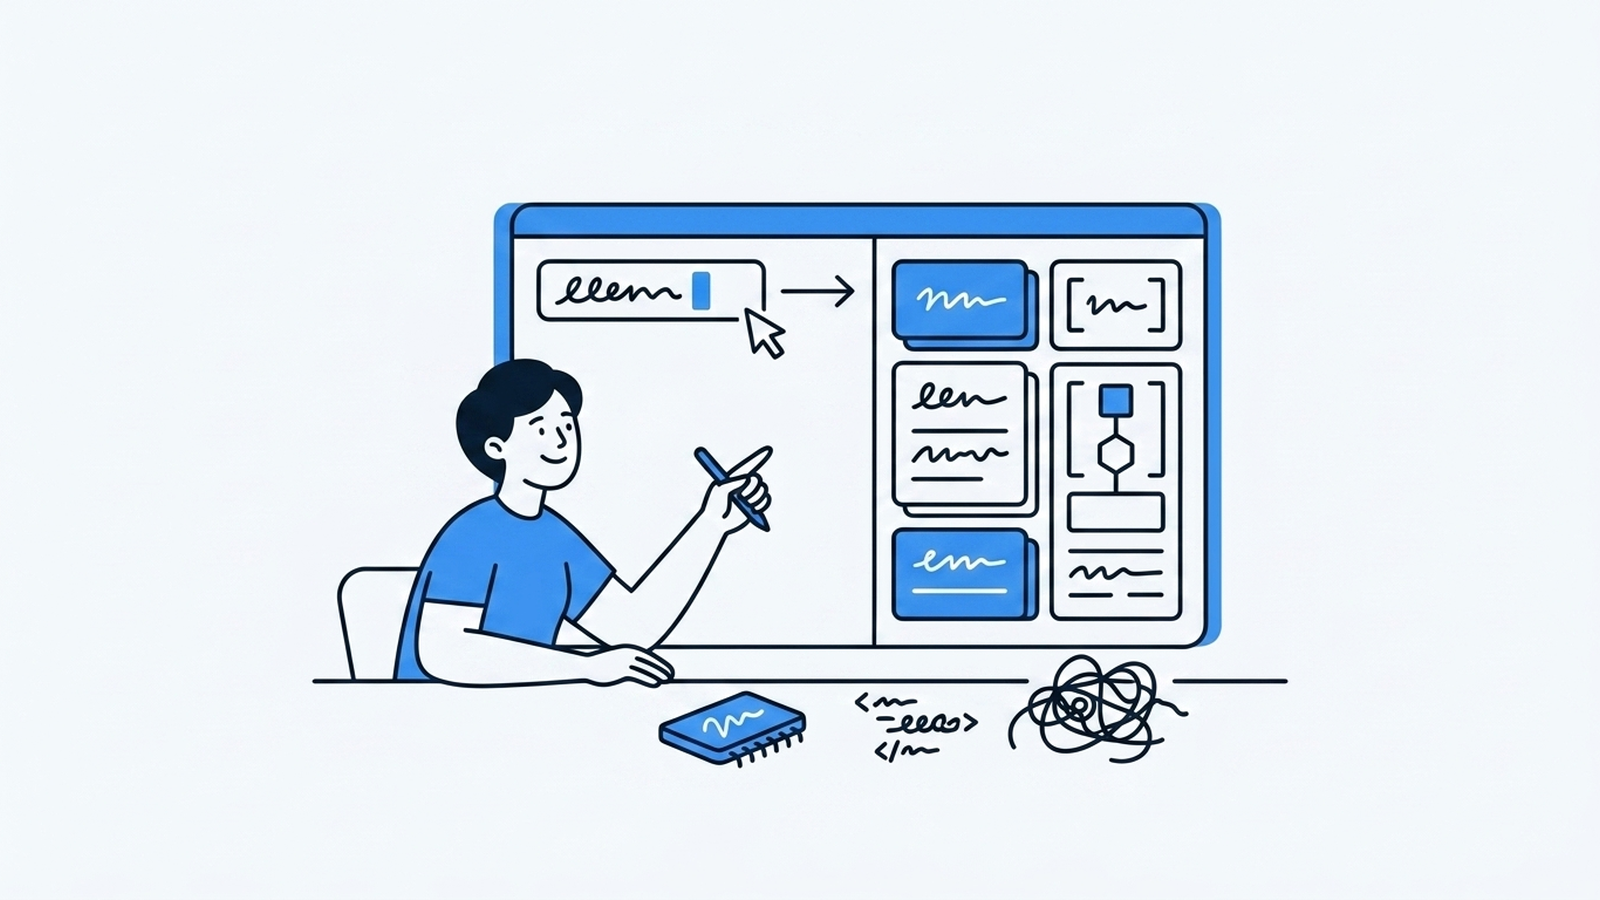
그림 1. 한 줄 prompt에서 설계된 context로 넘어가는 단계.
이 시리즈를 쓰게 된 건, LLM을 제품 코드에 붙이는 일을 오래 하다 보니 내가 일하는 방식 자체가 몇 번 크게 바뀌었기 때문이다. 처음엔 prompt 문장을 다듬는 데 시간을 썼고, 그다음엔 모델에게 코드를 맡겼고, 지금은 모델이 도는 실행 환경을 설계하는 데 시간을 더 쓴다. 그 변화를 순서대로 적어두면 나도 덜 헷갈리고, 비슷한 길을 걷는 사람에게도 지도 하나는 될 것 같았다. 1편은 가장 아래층인 prompt다.
prompting을 “잘 먹히는 주문 찾기”로 여기는 경우가 많다. “이렇게 쓰면 잘 나온다더라” 하는 문구를 모으는 식이다. 결과를 가르는 건 대개 그런 문구가 아니라 모델 앞에 무엇을 깔아 줬느냐였다. 그래서 나는 prompting을 LLM 활용의 첫 단계이면서, 동시에 가장 작은 단위의 context engineering이라고 본다.
이 시리즈의 순서
| 편 | 주제 | 다루는 것 |
|---|---|---|
| ① | Prompting | context 설계로 결과의 편차를 줄인다 |
| ② | Vibe coding | 의도만 말하면 code가 나오지만 검증이 빠진다 |
| ③ | Agents | 모델이 직접 tool을 쓰고 결과를 보며 반복한다 |
| ④ | Harness engineering | agent를 둘러싼 실행·검증 환경을 설계한다 |
| ⑤ | Open models | 직접 호스팅하고 튜닝할 수 있는 모델로 넓힌다 |
prompt는 빈칸을 줄이는 작업이다
막연하게 물으면 막연한 답이 온다. “이 주제로 글 써줘”라고만 하면 모델이 정해야 할 게 너무 많다. 어조, 길이, 형식을 매번 모델이 그 자리에서 고르니 호출할 때마다 다른 결과가 나온다.
좋은 prompt는 모델이 추측해야 하는 빈칸을 미리 메운다. 나는 네 가지를 먼저 채운다. 무엇을 만들지, 누구를 위한 것인지, 어떤 형식인지, 무엇을 피해야 하는지. 이 넷만 정해줘도 결과의 편차가 눈에 띄게 줄어든다. 모델은 그대로인데도 그렇다.
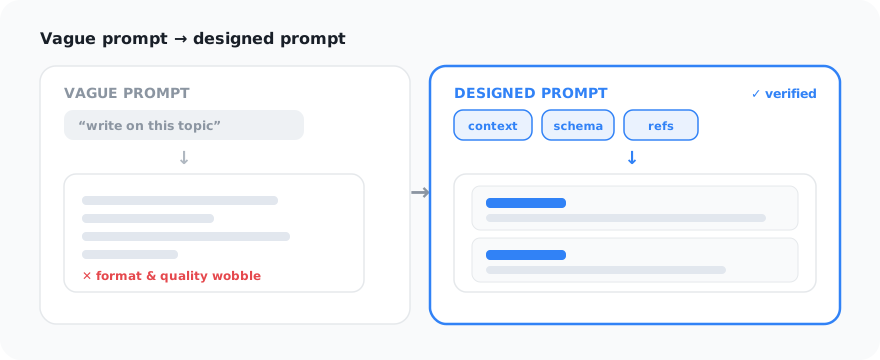
그림 2. 같은 모델이라도 한 줄 prompt와 설계된 context는 다른 출력을 낸다.
형식은 부탁하지 말고 강제한다
형식을 prompt 문장으로 부탁하는 것만으로는 자주 모자란다. “JSON으로 줘”라고 써도 가끔 앞에 설명 한 줄이 붙거나 줄바꿈이 어긋나고, 그 출력을 받는 parser가 그때마다 깨진다. 사람 눈에는 사소한 차이지만 코드에게는 장애다.
그래서 출력을 다른 코드가 받아 쓰는 자리라면 나는 형식을 부탁하지 않고 강제한다. Anthropic의 tool_use [1]나 OpenAI의 function calling [2]으로 출력 schema를 고정하면 모델은 그 구조로만 답한다.
# (1) 막연한 prompt: 형식이 매번 흔들린다
resp = await client.messages.create(
    model="claude-opus-4-8",
    messages=[{"role": "user", "content": "Make 6 slides on this topic"}],
)
text = resp.content[0].text   # 머리말·줄바꿈이 매번 달라서 parsing이 깨진다

# (2) tool_use로 schema를 고정: 이 구조로만 답한다
tools = [{
    "name": "emit_slides",
    "input_schema": {
        "type": "object",
        "properties": {
            "slides": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "title": {"type": "string"},
                        "body":  {"type": "string"},
                    },
                    "required": ["title", "body"],
                },
            },
        },
        "required": ["slides"],
    },
}]
resp = await client.messages.create(
    model="claude-opus-4-8",
    tools=tools,
    tool_choice={"type": "tool", "name": "emit_slides"},   # 이 tool을 반드시 호출
    messages=[{"role": "user", "content": prompt}],
)
slides = resp.content[0].input["slides"]   # 검증된 구조: 따로 parsing할 필요가 없다
(1)과 (2)는 모델도 주제도 같다. 달라진 건 출력을 설계했느냐 하나다. (2)에서는 parsing 에러가 사라지고, 빈 값이나 엉뚱한 field는 schema 단계에서 걸러진다. 나한테는 이 지점이 prompt를 “글”이 아니라 interface로 다루기 시작한 순간이었다. 함수 signature를 정하듯 출력의 모양부터 정해두면 그 뒤 코드가 단순해진다.
다만 schema가 막아주는 건 모양까지다. title과 body가 둘 다 채워져 있다는 건 보장되지만, 그 안의 문장이 맞는지, 6장을 요청했는데 정말 6장인지는 schema만으로는 알 수 없다. 형식 강제는 parsing 문제를 없애줄 뿐 내용 검증을 대신하지는 않는다. 이 구분을 놓치면 “structured output을 쓰니 안전하다”는 착각에 빠지기 쉽다.
어조는 설명보다 예시로 전한다
구조를 잡아도 어조는 별개의 문제다. 모델은 내가 원하는 문체를 모른다. 그걸 말로 길게 설명하기보다 실제로 잘 됐던 예시 몇 개를 같이 넣는 편이 낫다. few-shot이다. “이런 느낌으로 써줘”라는 설명 열 줄보다 진짜 예시 두 개가 어조를 훨씬 정확하게 옮긴다.
여기서 한 걸음 더 가면, 매번 손으로 예시를 붙이는 대신 어조와 배경 정보를 한 번 정의해 두고 prompt 앞에 자동으로 붙이는 구조가 된다. 그러면 산출물 종류가 달라도 같은 context를 물려받는다. prompt가 매번 새로 쓰는 일회용 문장에서 재사용하는 context로 바뀐다. 엔지니어 입장에서는 이게 prompt를 코드처럼 관리하기 시작하는 지점이고, 버전을 남기고 바꾼 결과를 비교할 수 있게 된다.
한 번의 호출로는 닿지 않는 곳
여기까지만 해도 prompt로 꽤 멀리 간다. 그래도 prompt에는 구조적인 한계가 셋 있다.
- 상태가 없다(stateless): 요청 하나와 응답 하나가 전부다. 모델은 방금 자기가 뭘 했는지, 그게 실제로 동작했는지 모른다.
- 도구가 없다(toolless): code를 실행하거나 파일을 읽거나 결과를 확인할 수 없다. 머릿속에 있는 것만으로 답한다.
- 검증이 없다: 틀려도 틀린 줄 모른다. 맞는지 확인하고 고치는 일은 전부 사람이 한다.
앞에서 schema가 내용까지는 지켜주지 못한다고 한 것도 결국 세 번째 한계에서 나온다. 이 세 가지가 다음 단계를 불렀다. “한 번에 다 쓰지 말고, 모델이 code를 쓰게 한 다음 돌려보면서 고치자”는 흐름이 vibe coding이고, “모델이 직접 tool을 쓰고 결과를 보면서 반복하게 하자”는 흐름이 agent다.
내가 지금도 지키는 것
prompting은 LLM을 다루는 첫 방식이고, 그 위에 무엇을 쌓든 지금도 바닥에 깔려 있다. 나는 세 가지를 지킨다. 빈칸을 줄인다. 형식은 부탁하지 않고 schema로 강제한다. 어조는 설명 대신 예시로 준다. 같은 모델에서도 이것만으로 안정성이 크게 달라진다.
그래도 prompt 한 번으로는 상태도, 도구도, 검증도 얻을 수 없다. 다음 편에서는 이 한계를 처음 흔든 방식인 vibe coding을 다룬다.