source attribution은 RAG 답변의 근거가 retrieval로 가져온 문서 가운데 어느 것이었는지를 문서별 점수로 가려내는 작업이다. 문서 n개의 부분집합을 전부 평가해 정확히 계산하려면 LLM 호출이 $2^{n}$ 번 필요하다. 반면 Kernel SHAP 같은 저렴한 근사는 표본 100개만으로 정확한 Shapley와의 Pearson 상관이 0.95를 넘는다. 문제는 문서끼리 얽힐 때다. 앞자리에 놓인 문서는 점수가 부풀고, 답을 합성하는 데 빠질 수 없는 문서는 일관되게 낮게 잡힌다 [1]. 이 글에서 다루는 논문은 Nematov 등이 2025년에 낸 Source Attribution in Retrieval-Augmented Generation 이다. Shapley 값을 문서 단위 기여 측정에 적용하는 방법과, 그 방법이 어디서 깨지는지를 같이 다룬다 [1].
RAG를 production에 붙여본 사람이면 겪는 장면이 있다. 문서 열 개를 넣었는데 답이 틀렸고, 어느 문서가 그 답을 만들었는지 모른다. retriever가 엉뚱한 걸 올린 건지, 쓸 만한 걸 올렸는데 모델이 안 쓴 건지, 넣은 문서 하나가 오히려 답을 망친 건지. 정답 여부 하나로만 보면 이게 전부 한 덩어리로 뭉개진다. 근거를 문서별 점수로 지목할 수 있으면 사용자에게 출처를 보여줄 수 있고, 방해만 되는 문서를 걸러 retrieval을 손볼 수도 있다. 이 논문이 끌린 건 그 지목을 “얼마면 할 수 있나”와 “언제 틀리나”로 갈라서 각각 숫자로 봤다는 점이다. 아래는 arXiv 본문과 수식·실험 수치를 원문과 대조한 메모다. 공개 코드(iNema9590/LLMX)나 데이터를 직접 돌려보지는 않았고, 저자들과 관계는 없다 [1][5].
비용이 먼저 막는다
걸림돌은 계산 비용이다. 기존 귀속 기법은 입력을 바꿔 가며 모델을 반복 실행하는 구조인데, LLM에서는 실행 한 번이 API 호출 한 번이고 그만큼 돈과 시간이 든다. 문서 n개의 부분집합을 빠짐없이 평가하는 정확한 계산에는 호출이 $2^{n}$ 번 필요하고, 문서 수가 조금만 늘어도 감당할 수 없게 된다 [1].
논문이 세운 목표는 세 갈래다. 이미 검증된 귀속 원리를 RAG의 문서 단위에 적용하기, 저렴한 근사법이 정확한 귀속에 얼마나 가까운지 측정하기, 그리고 문서끼리 겹치거나 서로 보완하거나 함께 있어야 답이 되는 까다로운 상황에서도 쓸 수 있는지 검증하기다 [1].
문서를 게임 참가자로 놓기
출발점은 문서 하나하나를 협력 게임의 플레이어로 취급하는 것이다. 문서 집합 $D$ 가 있을 때 문서 $j$ 의 Shapley 값은, $j$ 가 빠진 모든 부분집합 $S$ 에 대해 $j$ 를 넣었을 때 생기는 효용 증가분을 가중 평균한 값이다 [3][4].
\[\phi_j(v) = \sum_{S \subseteq D \setminus \{j\}} \frac{|S|!\,(|D|-|S|-1)!}{|D|!}\,\bigl[\,v(S \cup \{j\}) - v(S)\,\bigr] \tag{1}\]그러면 효용(utility)을 무엇으로 볼지가 핵심 설계 결정이 된다. 논문의 정의는 이렇다. 질의 $Q$ 와 문서 부분집합 $S$ 만 입력했을 때, 전체 문맥으로 만들었던 원래 답변 $R$ 이 다시 나올 log-likelihood. 값은 teacher forcing으로 $R$ 의 토큰별 로그확률을 합산해 구한다 [1][2].
\[v(S) = \sum_{t=1}^{|R|} \log P\bigl(\mathrm{token}_t(R)\,\big|\,\mathrm{token}_{<t}(R),\, Q,\, S\bigr) \tag{2}\]어떤 문서 묶음을 줬을 때 원래 답이 더 그럴듯하게 나온다면 그 묶음의 효용이 크다고 본다. 효용을 이렇게 잡아 두면 SHAP이나 ContextCite처럼 원래 있던 attribution 기법을 RAG에 손대지 않고 적용할 수 있다 [1][2].
비교 대상에는 정확한 Shapley, TMC-Shapley, Beta-Shapley, Kernel SHAP, ContextCite, 그리고 문서를 하나씩 빼 보는 가장 단순한 LOO(leave-one-out)가 들어간다. 모델로는 LLaMA-3.2-8B, Mistral-7B, Qwen-3B를 썼고, 데이터는 BioASQ, Natural Questions와 함께 저자들이 따로 설계한 가상 시나리오를 썼다 [1].
실험 1. 근사법은 정확한 Shapley에 얼마나 가까운가
첫 번째 실험의 질문은 근사법이 매긴 순위가 정확한 Shapley 순위와 얼마나 일치하느냐다. 지표로는 Pearson 상관, Kendall’s Tau, Precision@k를 쓴다.
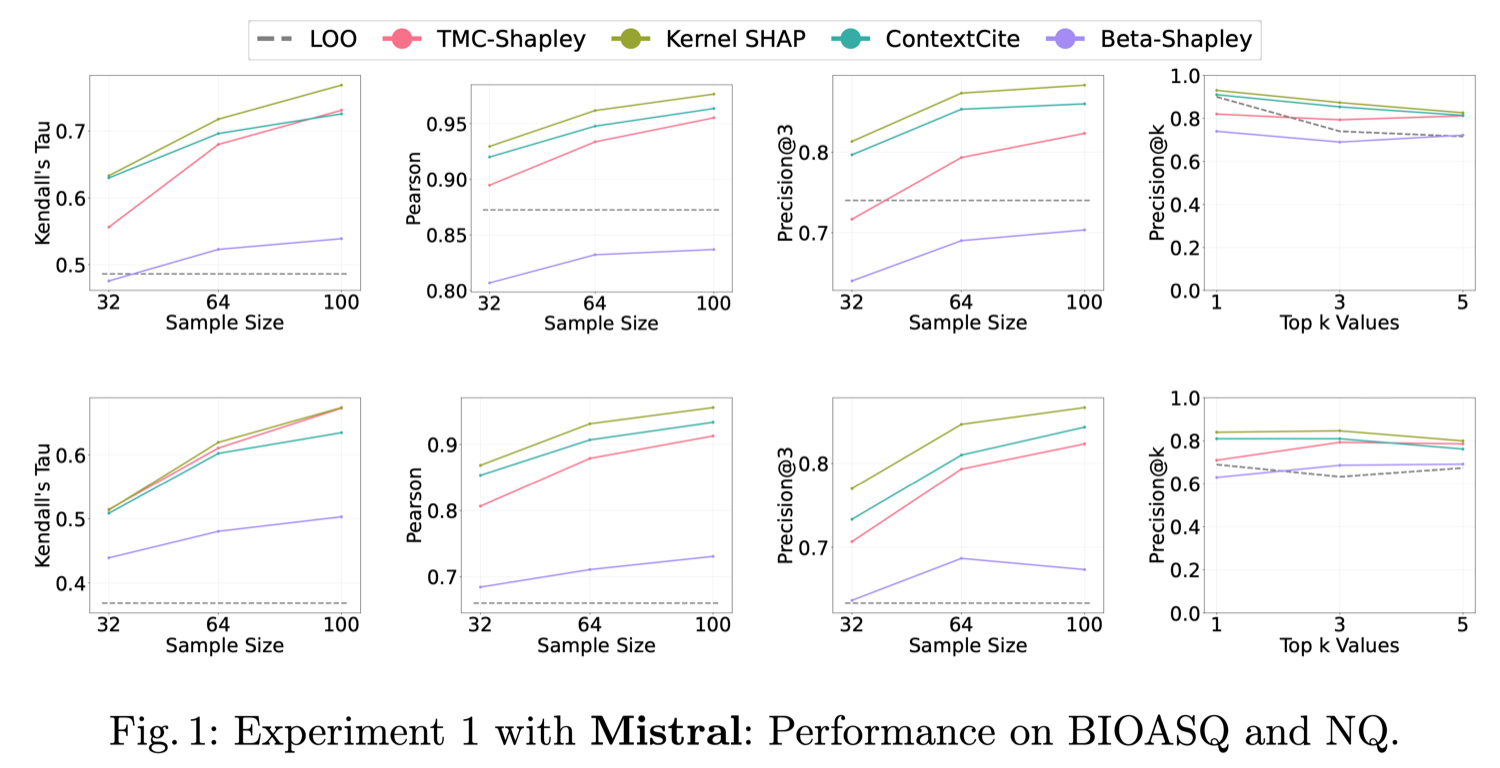
그림 1. Mistral로 BIOASQ·NQ를 돌렸을 때, 표본 32·64·100에서 근사법별로 정확한 Shapley를 얼마나 따라가는지.
대부분의 지표에서 가장 정확한 쪽은 Kernel SHAP이었고, ContextCite가 아주 조금 뒤에 있었다. 둘 다 간단한 surrogate 선형 모델을 학습하는 방식이어서, 표본을 32, 64, 100으로 늘릴수록 성능이 꾸준히 오르고 Pearson 상관은 0.95를 넘긴다. TMC-Shapley, Beta-Shapley, LOO는 확연히 뒤였다 [1]. 상위 1개 문서를 맞히는지 보는 Precision@1도 대부분 0.8보다 높았다. 싼 근사로도 가장 중요한 근거 문서는 잘 찾아낸다 [1].
실험 2. 빼면 답이 무너지는 문서 찾기
두 번째 실험은 제거했을 때 답이 가장 많이 망가지는 상위 k개 문서를 각 방법이 맞히는지 Precision@k로 잰다. 정확한 Shapley가 예상대로 최고점이거나 그에 가까웠고, Kernel SHAP과 ContextCite도 거의 같은 수준으로 찾아냈다. 선형 모델이 additivity(가법성) 공리를 만족하기 때문이다 [1]. 그래도 어느 방법이든 조금씩 빗나가는 부분이 있었다. 그 이유가 문서 사이의 의존성이고, 세 번째 실험이 이 문제를 따로 다룬다.
실험 3. 문서끼리 의존하면 점수가 틀어진다
이 논문에서 가장 볼 만한 부분은 문서들이 서로 관계를 가질 때의 결과다. 저자들은 가상 데이터로 세 가지 상황을 만들었다. 모델이 사전지식으로 정답을 알아버리지 않도록 지명과 인물을 실재하지 않는 것으로 채웠다 [1].
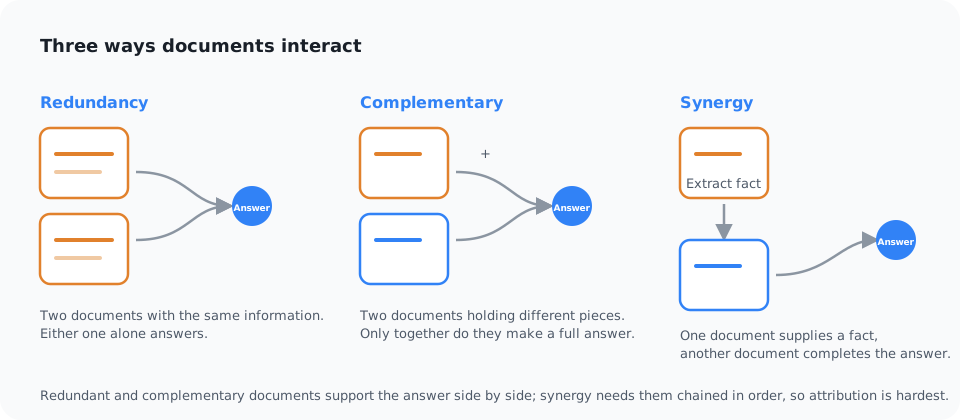
그림 2. 문서가 서로 엮이는 세 형태인 중복, 상보, 시너지.
첫 번째 상황은 중복(redundancy)이다. 두 문서에 사실상 같은 정보가 들어 있어서 둘 중 아무거나 있어도 답이 나온다.
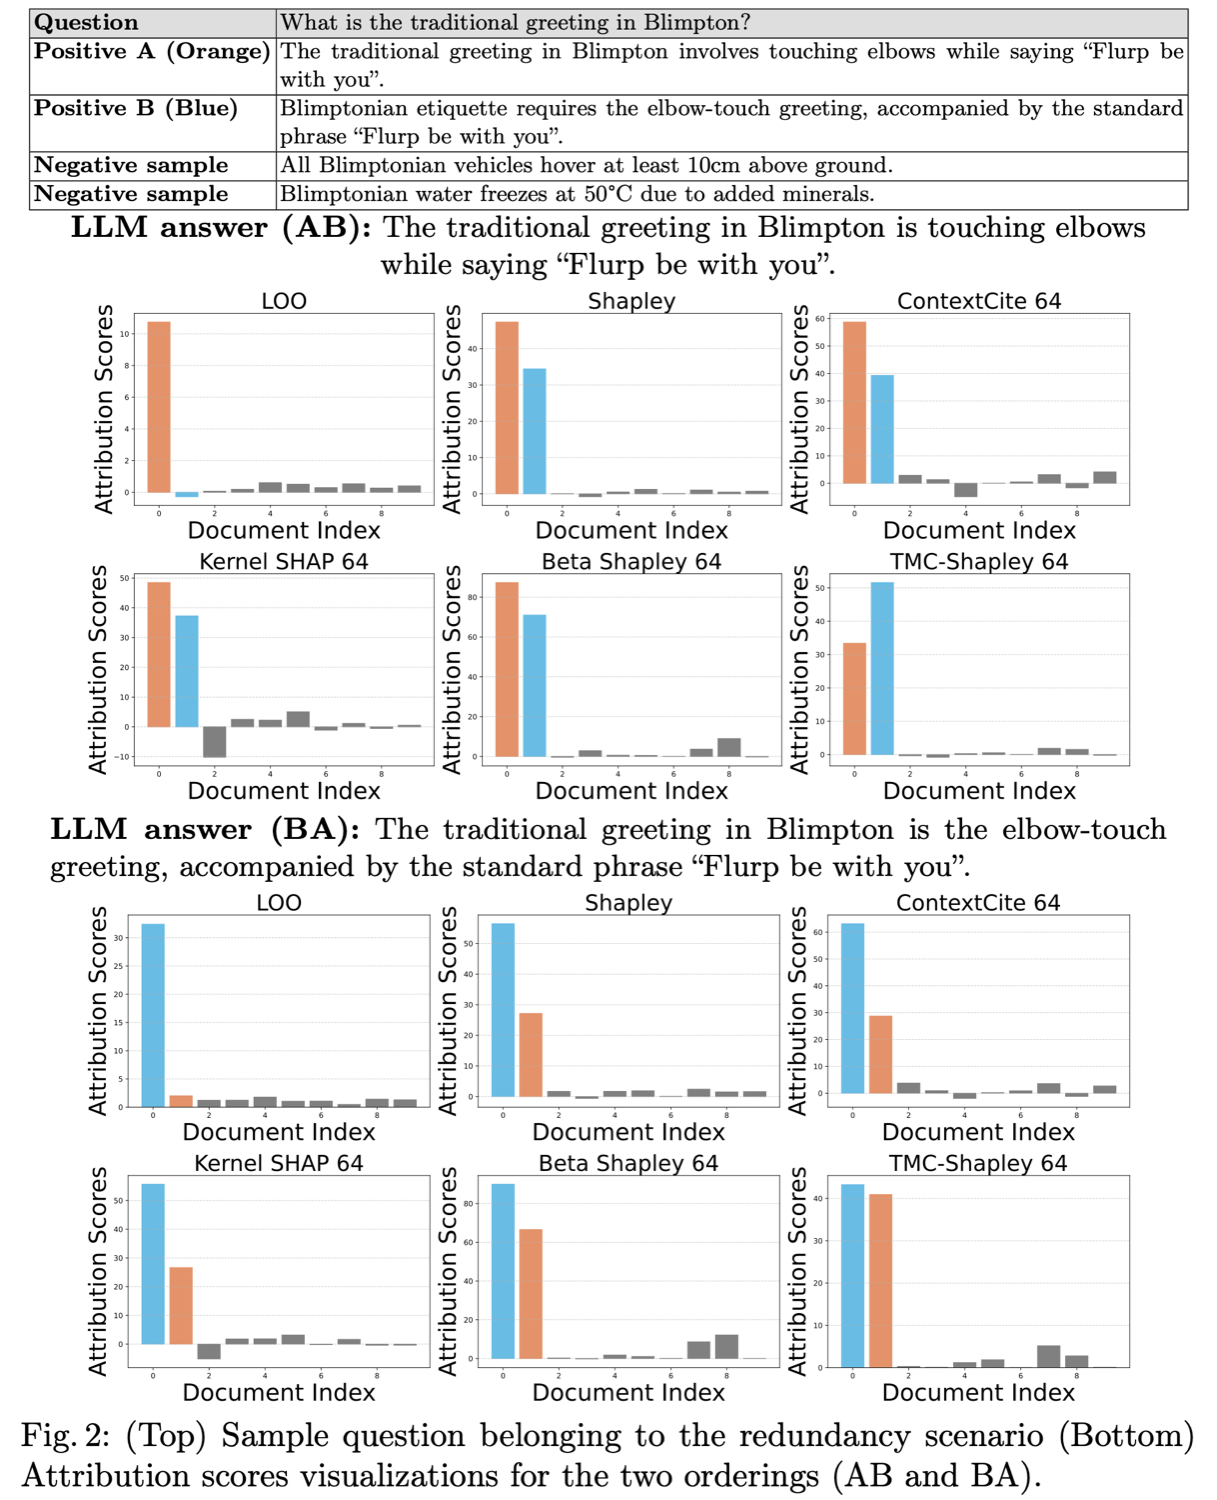
그림 3. 중복 시나리오. 두 문서 자리를 맞바꿔도 높은 귀속은 늘 앞쪽 문서가 가져간다.
이 상황에서 position bias가 보인다. 중복된 두 문서 중 앞쪽에 놓인 것이 매번 더 높은 점수를 받았고, 순서를 바꾸면 편향 방향도 같이 바뀌었다. 정보는 똑같은데 놓인 위치가 점수를 정한 셈이다 [1].
두 번째 상황인 상보(complementary)에서는 두 문서가 각자 다른 조각을 쥐고 있어서, 둘을 합쳐야 답이 완성된다. 여기서는 어느 방법이든 두 문서를 모두 잘 잡아냈다. 걸리는 건 효용 값만 봐서는 이 경우와 중복을 가려내기 어렵다는 점이다. 어느 쪽이든 한 문서가 높고 나머지 하나가 약간 낮게 나온다 [1].
세 번째 시너지(synergy)는 다단계 추론이 필요한 상황이다. 한 문서에서 얻은 사실을 다른 문서에 이어 붙여야 답이 나온다.
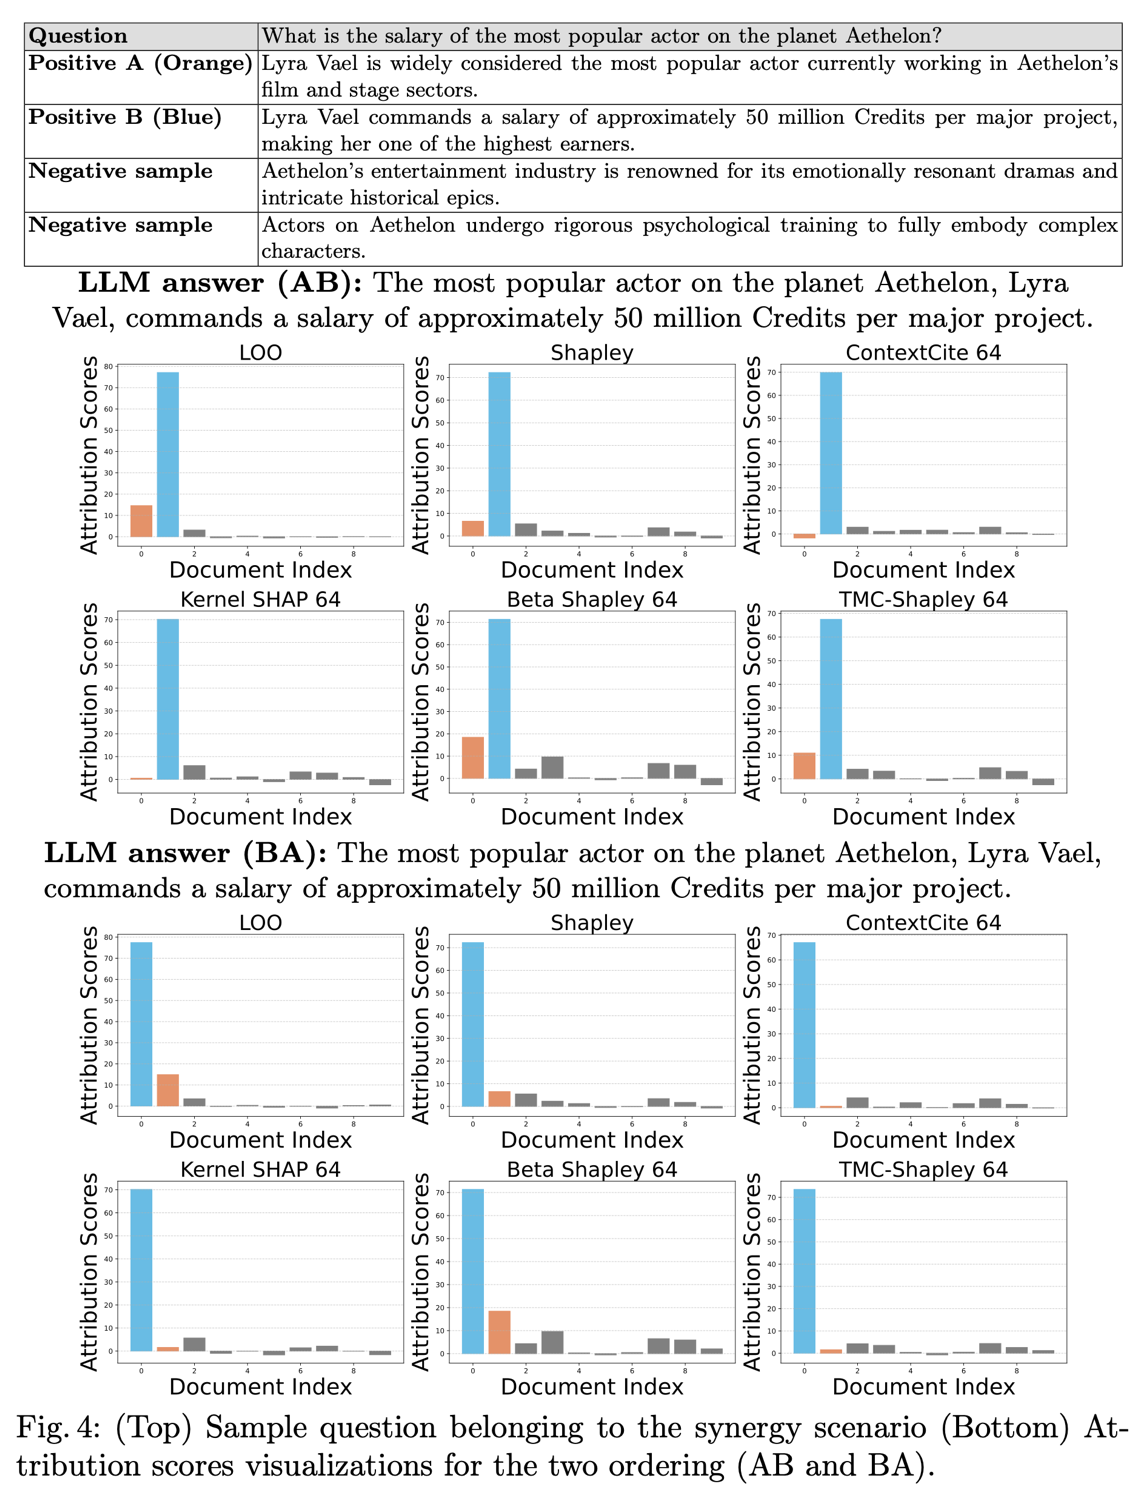
그림 4. 시너지 시나리오. 답을 직접 담은 문서만 점수가 높고, 답을 엮는 데 필요한 문서는 낮게 잡힌다.
여기서는 모든 방법이 답을 직접 갖고 있는 문서에 점수를 집중시켰고, 합성 과정에서 없어서는 안 되는 다른 문서는 낮게 평가했다. 문서 순서를 바꿔도 높은 점수를 받는 문서가 그대로였으니 position bias로 설명되는 현상도 아니다. 질문 전체에 걸쳐 A, B 두 문서의 점수를 정규화하고 평균을 내 보면, 답이 들어 있는 B가 종합에 필요한 A보다 일관되게 크게 앞선다 [1].
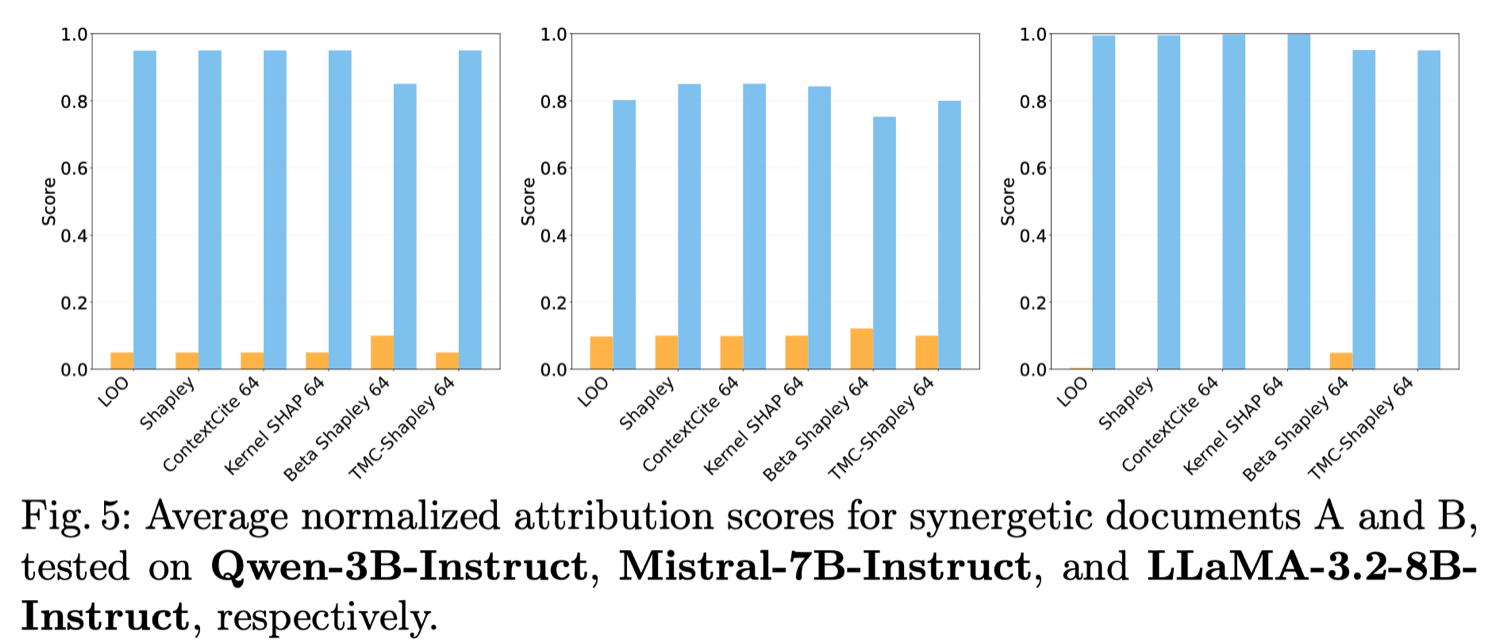
그림 5. 세 모델 모두에서 시너지 문서 A·B의 정규화 귀속 점수 평균을 비교하면 종합에 쓰이는 문서 쪽이 계속 낮다.
이 방법의 한계
효용 함수를 RAG에 맞게 정의하면 source attribution은 적은 비용으로도 꽤 쓸 만하다. 다만 넘지 못하는 선도 분명하다 [1].
- 비가법성(non-additivity): log-likelihood 기반 효용에는 더해지는 성질이 없어서, Shapley가 이론적으로 보장하는 성질이 온전히 성립하지 않는다.
- position bias: 같은 내용이어도 앞에 놓인 문서의 점수가 부풀려진다.
- 관계 혼동: 효용 값만으로는 중복인지 상보인지 가려내기 어렵다.
- 종합 과소평가: 다단계 추론에서 답을 합성하는 데 쓰인 문서의 점수가 체계적으로 낮다.
내가 이걸 RAG 디버깅에 쓴다면
이 절은 논문이 아니라 내 해석이다. 논문 자체는 attribution을 어떻게 재느냐에 관한 것이지만, production RAG를 만드는 입장에서 바로 챙길 건 세 가지다.
첫째, attribution 점수를 디버깅 신호로 쓰되 한 문서만 보지 않는다. 답이 틀렸을 때 Kernel SHAP으로 문서별 기여를 뽑아보면 retriever가 엉뚱한 걸 올렸는지, 모델이 올라온 걸 안 썼는지가 갈린다. 표본 100개로 Pearson 0.95를 넘기니 정확한 Shapley를 $2^{n}$ 호출로 돌릴 필요도 없다. 다만 점수 하나로 “이 문서가 근거다”라고 단정하지는 않는다. 다음 두 함정 때문이다.
둘째, 순서를 믿지 않는다. 같은 내용인데 앞에 놓였다는 이유로 점수가 높아지는 position bias가 있으니, 디버깅용으로 attribution을 돌릴 땐 문서 순서를 섞어 두세 번 재고 결과가 자리 따라 뒤집히는지부터 본다. 뒤집히면 그 점수는 근거가 아니라 자리다.
셋째, 시너지 문서를 놓치지 않는다. 다단계 추론 질문에서는 직접 답을 담은 문서만 높게 나오고 종합에 필요한 문서가 눌린다. “기여 낮으니 빼도 된다”고 retrieval에서 쳐내면 멀쩡한 답이 깨질 수 있다. 그래서 낮은 점수 문서를 버리기 전에 그걸 빼고 실제로 답이 유지되는지 한 번 돌려본다. 점수는 후보를 좁히는 용도지 최종 판정이 아니다.
덧붙이면, 실험 모델이 LLaMA-3.2-8B·Mistral-7B·Qwen-3B로 모두 작은 오픈 모델이고, 관계 실험도 실재하지 않는 지명과 인물로 꾸민 가상 시나리오라 실제 법률·의료 문서의 얽힘을 다 담지는 못한다. 그래서 나는 이 숫자를 “내 production 설정에서의 상한선”이 아니라 “attribution 점수를 어떻게 의심해야 하는지”의 지도로만 가져간다.
Nematov et al., “Source Attribution in Retrieval-Augmented Generation”, arXiv:2507.04480 (2025).
References
- Nematov et al., “Source Attribution in Retrieval-Augmented Generation”, arXiv:2507.04480 (2025)
- Cohen-Wang et al., “ContextCite: Attributing Model Generation to Context”, NeurIPS 2024
- Lundberg & Lee, “A Unified Approach to Interpreting Model Predictions (SHAP)”, NeurIPS 2017
- Ghorbani & Zou, “Data Shapley”, ICML 2019
- 실험·구현 코드 (iNema9590/LLMX)