Google Research의 R4T 논문은 query fan-out을 groundedness·diversity·원래 query와의 alignment라는 set-level reward로 RL 학습한 다음, 그 행동을 53.9M 파라미터 diffusion model에 옮겨 query set 전체를 한 번에 생성하게 했다. query를 펼치는 layer가 redundancy를 줄이도록 명시적으로 학습되고 있다는 신호다. 다만 그 diversity가 사실형 검색에서도 옳은 목표인지는 이 논문이 보여주지 않는다. 논문은 Pengcheng Jiang, Judith Yue Li 등 Google Research와 UIUC 연구진 11명이 쓴 “Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion”이다 [1]. ICML 2026 poster로 발표됐고 [3], Google Research 블로그가 2026년 9월에 해설 글을 냈다 [2].
fan-out에는 잘 알려진 약점이 있다. LLM에게 “이 질문을 sub-query 10개로 펼쳐라”라고 시키면 단어만 바꾼 비슷한 query가 섞여 나온다. 그러면 retrieval을 여러 번 호출해도 돌아오는 문서 종류는 호출 수만큼 늘지 않는다. 비용은 호출 수에 비례해 오르는데 recall은 그만큼 오르지 않는다. 이 논문은 그 현상에 이름을 붙이고 reward로 막으려 했고, 그 결과를 production latency 안에 넣으려고 구조까지 바꿨다. 그래서 읽었다. 아래는 2026년 10월 기준 arXiv 2603.06397 v1(2026-03-06 제출)과 Google Research 블로그 해설을 대조해 읽은 메모이고, 숫자는 전부 논문 본문과 표에서 가져왔다 [1][2]. 실험을 직접 재현하지는 않았고 저자들과 관계는 없다. 보고된 speedup은 set-valued recommendation 과제의 latency 결과이고, 논문에 웹 검색 ranking이나 AI 답변 citation에 대한 결과는 없다.
query fan-out은 왜 set 문제인가
fan-out retrieval이 잘 됐는지는 sub-query 하나가 아니라 set 전체로 정해진다. 논문은 이를 “set-valued and non-decomposable” retrieval 문제라고 부른다 [1]. broad intent가 들어오면 시스템은 결과 하나가 아니라 collection을 돌려줘야 하고, 그 collection은 diversity, intent coverage, complementarity 같은 higher-order property를 만족해야 한다. 동시에 database에 실제로 있는 item에 grounded 돼 있어야 한다.
Google Research 블로그는 이걸 캠핑 장비 예시로 설명한다. “camping gear”를 검색한 사람은 4인용 텐트의 미세한 변형 열 개를 원하지 않는다 [2]. 텐트, 침낭, 버너, 헤드램프처럼 서로 보완하는 set이 좋은 답이다.
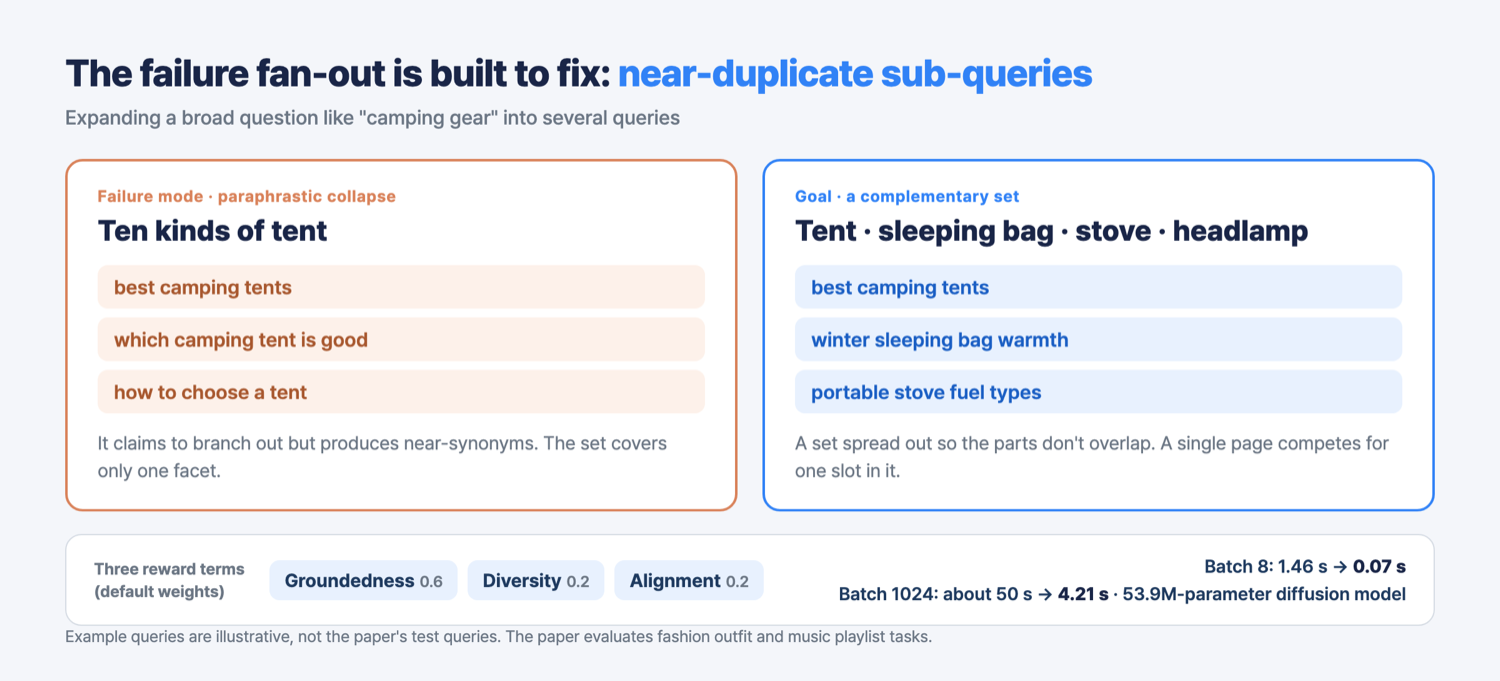
그림 1. 왼쪽은 거의 같은 뜻의 sub-query만 만드는 paraphrastic collapse, 오른쪽은 서로 겹치지 않게 벌린 query set이다. 아래 띠는 reward 세 항의 기본 가중치와 batch 8, batch 1024에서의 latency를 정리했다. query 예시는 설명용이다.
여기서 supervised 학습의 한계가 드러난다. 학습 데이터는 보통 (query, 정답 하나) pair라 top-1 retrieval만 가르친다 [1]. “이 query들이 서로를 보완해야 한다”는 조건은 개별 query에 붙는 label로 쓸 수가 없다. 정답 set도 하나로 정해지지 않는다. 같은 broad intent에 맞는 set이 여럿일 수 있으니 ground-truth label을 모으는 일 자체가 비싸고 주관적이다.
RL은 set-level reward를 직접 최적화할 수 있으니 이 문제에 맞는다. 문제는 RL로 튜닝한 language model을 inference 때마다 돌리면 너무 느리다는 점이다. sub-query를 순서대로 생성하고, query마다 retrieval을 호출한다. 논문의 출발점은 이 두 요구를 떼어놓는 것이다.
R4T의 3단계: RL은 한 번, inference는 diffusion model
R4T(Retrieve-for-Train)는 RL을 배포용 inference engine이 아니라 “objective transducer”로 한 번만 쓴다 [1]. 비싼 exploration을 offline에서 한 번 해두고 그 결과를 작은 모델에 distill한다. 제목의 “RL-Compiled”가 이 뜻이다. 엔지니어 입장에서 이 framing이 마음에 들었다. RL을 serving path에서 빼고 training-time 도구로만 쓰면, 운영 중에 감당해야 할 건 작은 모델 하나의 latency뿐이다.
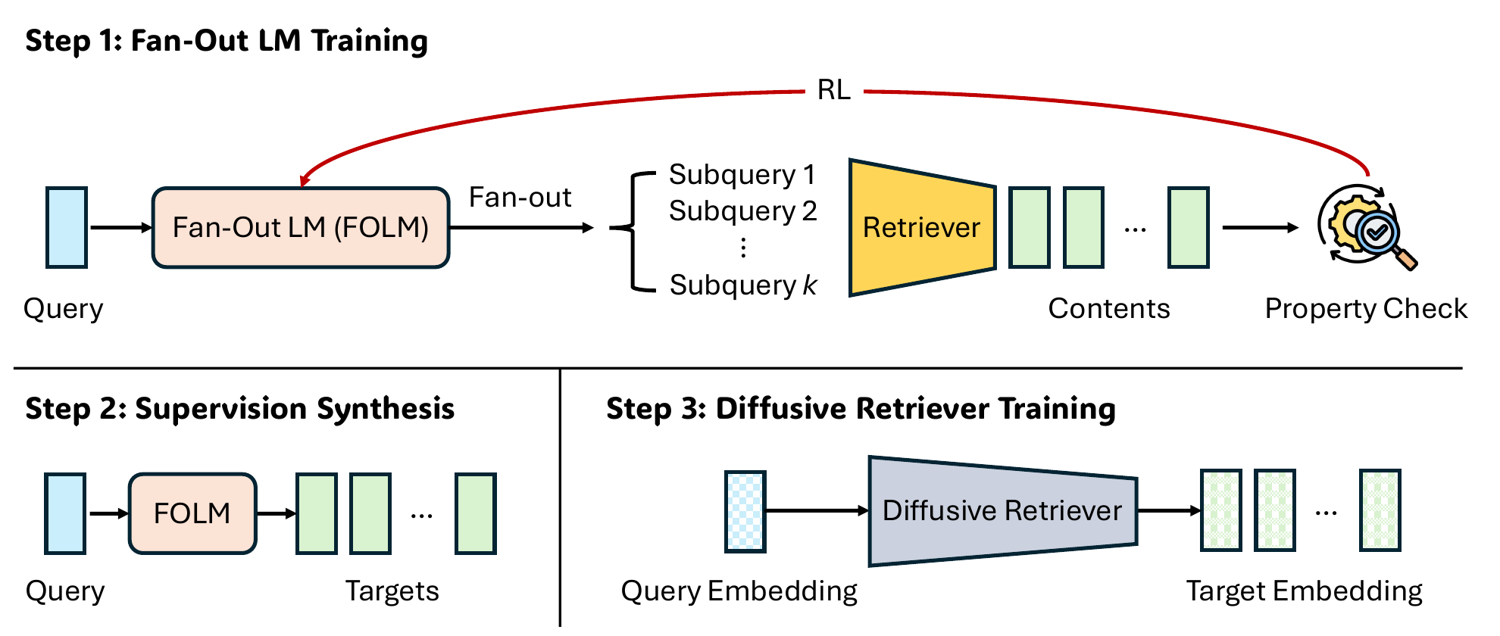
그림 2. R4T의 세 단계. 1단계에서 fan-out language model(FOLM)이 sub-query를 만들고, retrieval 결과의 property check로 RL reward를 받는다. 2단계에서 학습된 FOLM으로 query와 target pair를 합성하고, 3단계에서 query embedding을 받아 target embedding set을 내놓는 diffusion retriever를 학습한다 [1].
| 단계 | 하는 일 | 논문 설정 |
|---|---|---|
| 1. fan-out language model 학습 | broad query에서 sub-query k개 생성, frozen retriever로 검색, set-level reward로 RL | Gemma3-4B·Qwen3-4B, GRPO + Soft-PPO regularization, group size 8 |
| 2. training data 합성 | 학습된 FOLM을 돌려 reward 높은 trajectory를 모아 (query embedding, target embedding set) pair로 변환 | query당 128 sample, temperature 0.9 |
| 3. diffusion retriever 학습 | query embedding을 조건으로 target embedding set 전체를 한 번에 생성 | 6-layer 16-head transformer, embedding 128차원, set 길이 12, sampling 256 step |
표 1. R4T의 세 단계와 논문이 밝힌 주요 설정 [1].
배포 형태는 둘이다. R4T-FOLM은 RL로 학습한 language model을 그대로 inference에 쓰고, R4T-Diffusion은 그 행동을 distill한 diffusion model을 쓴다 [1]. 둘을 나란히 놓으면 “reward로 최적화한 fan-out의 품질”과 “그걸 배포하는 비용”을 따로 볼 수 있다. diffusion model의 training target을 만들 때는 set 안의 row 순서를 무작위로 섞는다. set에는 순서가 없으니 모델이 순서에 기대지 못하게 하려는 장치다.
reward 세 항: groundedness, diversity, alignment
R4T의 reward는 groundedness, diversity, 원래 query와의 alignment 세 항의 가중합이고 기본 가중치는 0.6, 0.2, 0.2다 [1]. ground-truth set이 없는 open-ended abstract retrieval(OAR) 과제에서 쓰는 reward는 다음과 같다.
\[R_{\text{abs}}(q, Q) = \lambda_g\, r_{\text{ground}}(Q) + \lambda_d\, r_{\text{div}}(Q) + \lambda_a\, r_{\text{align}}(q, Q) \tag{1}\]$q$는 원래의 broad query, $Q={q_1,\dots,q_k}$는 생성된 sub-query set이다. groundedness $r_{\text{ground}}$는 각 sub-query embedding이 database에서 가장 가까운 item과 얼마나 가까운지를 잰다. 실제로 있는 것을 가리키는 query일수록 점수가 높다. alignment $r_{\text{align}}$은 각 sub-query와 원래 query의 cosine similarity 평균이라, 질문에서 벗어난 query를 깎는다.
\[r_{\text{div}}(Q) = \text{Vendi}\big(\{e_{\text{content}}(c^{\star}_i)\}_{i=1}^{k}\big) \tag{2}\]diversity $r_{\text{div}}$는 sub-query마다 대표 retrieval 결과 하나($c^{\star}_i$, 예를 들어 top-1 item)를 뽑고 그 embedding set에 Vendi Score를 계산한다 [1][4]. Vendi Score는 similarity matrix eigenvalue의 Shannon entropy에 exponential을 취한 값이라, set 안에 사실상 서로 다른 것이 몇 개 있는지를 세는 지표로 읽힌다 [4]. 이 설계에서 제일 중요하다고 본 부분은 query 문자열이 아니라 retrieval된 결과의 diversity를 잰다는 점이다. 표현만 바꾼 query가 같은 item을 가져오면 점수가 오르지 않는다. 앞에서 말한 “여러 번 호출해도 문서 종류는 그대로” 문제를 정확히 겨냥한 정의다. 문자열 diversity를 reward로 줬다면 모델은 동의어 사전을 학습했을 것이다.
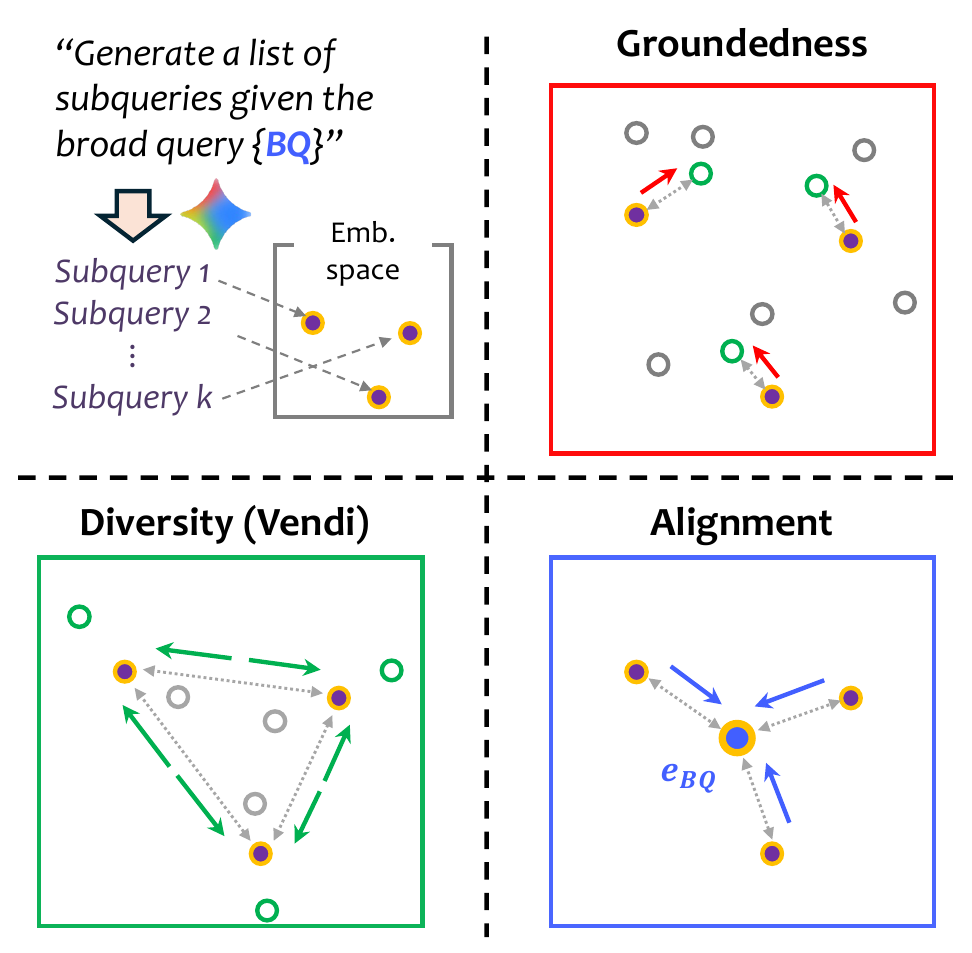
그림 3. OAR 과제의 reward 세 항. groundedness는 sub-query embedding을 실제 database item 쪽으로 당기고, diversity(Vendi)는 대표 결과끼리 벌리고, alignment는 각 sub-query를 원래 query embedding $e_{BQ}$ 쪽으로 당긴다 [1].
reference set 일부가 주어지는 weakly supervised compositional retrieval(WSCR) 과제에서는 reward가 다르다. reference set $Y$ 중 fan-out 결과에 들어간 비율을 reward로 준다 [1]. 논문은 이 reference set을 “유일한 정답이 아니라 그럴듯한 realization 하나”로 다룬다. 그래서 이 과제의 recall도 accuracy보다는 semantic coverage의 proxy로 해석한다.
diversity 항을 빼면 policy가 무너졌다
diversity 항이 왜 필요한지는 ablation에 있다. groundedness reward만으로 학습하면 policy가 “line ending line ending line ending” 같은 의미 없는 문자열로 수렴했다 [1]. 우연히 특정 database item과 embedding 거리가 가까운 문자열을 찾아낸 것이다. groundedness와 alignment를 같이 주면 collapse가 더 빨리 왔다. policy가 원래 질문을 바꿔 말한 query만 반복해서 alignment 점수를 쉽게 채웠다.
저자들은 이 실패를 paraphrastic collapse라고 부른다. “Bohemian festival style”이라는 query에 baseline(Qwen3-4B zero-shot)은 “bohemian festival style”, “bohemian festival fashion”처럼 거의 같은 표현을 냈고, R4T는 “bohemian festival dress”, “straw boots festival style”, “lace bohemian festival”처럼 서로 다른 방향으로 갈라졌다 [1]. 세 항을 함께 최적화해야 shortcut이 막히고 학습이 안정됐다.
이 ablation은 reward hacking 교과서 같은 사례다. embedding 기반 reward 하나만 주면 policy는 embedding 공간의 빈틈을 찾는다. 사람이 보기에 의미 없는 문자열이 reward 함수 입장에서는 정답이다. 각 항이 다른 항의 shortcut을 막는 구조여야 한다는 게 이 논문에서 가장 재사용 가치가 높은 교훈이라고 본다.
가중치를 바꾼 실험도 있다. groundedness 비중이 크면 diversity는 오르지만 alignment가 떨어졌고, alignment와 diversity 비중을 키우면 exploration이 줄어 다른 해석을 덮는 범위가 좁아졌다 [1]. 논문은 diversity와 alignment가 서로를 붙잡는 “mutual counter-anchor” 역할을 한다고 정리한다. 이 시스템의 diversity는 무한정 벌리는 쪽이 아니라 원래 질문에서 벗어나지 않는 범위 안에서 벌리도록 조율돼 있다.
결과: 품질 점수는 오르고 latency는 12–20배 줄었다
R4T는 두 dataset, 두 base model에서 zero-shot fan-out과 Best-of-N baseline보다 높은 점수를 냈다 [1]. dataset은 사용자가 꾸린 outfit 묶음인 Polyvore fashion benchmark와, 전문가가 만든 음악 playlist로 구성된 비공개 industrial dataset이다 [1][5]. candidate pool은 Polyvore task 1이 21,888개, task 2가 142,472개, 음악이 8,522개였다. 모든 fan-out 방법은 sub-query 10개를 만들었고, Best-of-N은 zero-shot fan-out을 5번 돌려 reward가 가장 높은 것을 골랐다.
| 방법 (Polyvore, Gemma3-4B) | Groundedness | Diversity | Alignment | 평균 |
|---|---|---|---|---|
| No fan-out | 22.4 | 34.4 | 21.4 | 26.1 |
| Zero-shot fan-out | 28.4 | 56.0 | 31.2 | 38.5 |
| Best-of-N | 28.9 | 61.0 | 32.7 | 40.9 |
| R4T-FOLM | 30.8 | 76.8 | 39.8 | 49.1 |
| R4T-Diffusion | N/A | 74.3 | 37.6 | N/A |
표 2. open-ended abstract retrieval(OAR) 과제의 Polyvore 결과 일부. LLM judge가 매긴 점수이고, diffusion 변형은 중간 sub-query가 없어 groundedness를 재지 않았다 [1].
같은 과제에서 음악 dataset의 Gemma3-4B 평균은 zero-shot 48.1, Best-of-N 49.2, R4T-FOLM 58.1이었다 [1]. Qwen3-4B로 바꾸면 Polyvore 평균이 같은 순서로 28.1, 30.4, 42.6이었다. fan-out을 아예 안 하는 baseline은 모든 조건에서 가장 낮았다. 논문은 이를 “fan-out is necessary but not sufficient”로 요약한다. query expansion이 더 많은 semantic facet을 덮는다는 오래된 가설은 확인됐고, zero-shot fan-out은 database에서 벗어나거나 거의 같은 query로 무너지는 약점을 보였다. Best-of-N이 zero-shot보다 조금밖에 안 오른 것도 눈여겨볼 만하다. 같은 분포에서 다섯 번 뽑아 고르는 것으로는 collapse 경향 자체가 바뀌지 않는다.
WSCR 과제에서는 coverage와 diversity 사이의 trade-off가 드러났다. Qwen 기반 R4T-FOLM은 Recall@5K 20.9, Hit@5K 64.6으로 coverage가 가장 높았지만 Vendi Score는 27.5로 zero-shot Qwen(46.4)보다 낮았다 [1]. diffusion 변형은 Recall@5K 16.5, Hit@5K 57.5, Vendi 34.7로 그 사이에 있었다. reference set과의 overlap을 reward로 줄수록 결과가 소수의 dominant meaning으로 몰렸다. 논문은 reference set이 유일한 정답이 아니므로 낮은 recall이 곧 낮은 품질은 아니라고 덧붙인다.
| Batch size | Autoregressive LM fan-out | Diffusion model fan-out |
|---|---|---|
| 8 | 약 1.46 s | 0.07 s |
| 1024 | 약 50 s | 4.21 s |
표 3. sub-query 10개 분량의 fan-out 생성 latency. diffusion model은 53.9M 파라미터이고, 논문은 batch 크기 전반에서 12–20배 speedup으로 요약한다 [1].
속도 숫자는 정확히 읽어야 한다. 작은 batch에서는 1초 아래였지만 batch 1024에서는 diffusion model도 4.21초가 걸렸다 [1]. “50초가 1초 아래로”는 과장이고, 논문이 실제로 보인 건 “같은 batch에서 한 자릿수 초로, 12–20배”다.
왜 diffusion인가: set에는 순서가 없다
diffusion model을 고른 이유는 출력의 모양에 있다. autoregressive 생성은 sub-query를 하나씩 순서대로 내보낸다. 텐트와 침낭 중 뭐가 먼저인지는 정해져 있지 않은데, 순차 생성은 없는 순서를 만들어 그 순서대로 출력한다. diffusion model은 noise에서 출발해 set 전체를 동시에 다듬어 한 번에 내놓으니, unordered set이라는 출력 구조와 맞는다 [1].
논문은 이 전환을 무거운 “System 2” autoregressive 생성에서 가벼운 “System 1” parallel sampling으로 옮기는 것이라고 표현한다 [1]. diffusion model은 query embedding을 cross-attention으로 받고, probability flow ODE를 풀어 embedding set을 만든 다음, 각 embedding을 nearest-neighbor retrieval로 실제 item에 연결한다. 12–20배 speedup은 이 설계의 결과로 읽힌다. 목표는 “set-level property를 production latency 안에서 지키는 것”이었다.
이 구조에서 하나 짚고 싶은 건 출력이 텍스트 query가 아니라 embedding이라는 점이다. sub-query 문자열이 사라지니 groundedness를 잴 중간 산출물이 없고(표 2의 N/A), 디버깅할 때 “모델이 뭘 찾으려 했는지”를 사람이 읽을 수 없다. 대신 embedding space가 바뀌면 diffusion model도 다시 학습해야 한다. latency를 얻는 대가로 interpretability와 index 교체 유연성을 내준 셈이다.
한계: diversity가 검색에서도 옳은지는 보여주지 않았다
논문이 스스로 밝힌 한계는 네 가지다 [1]. 첫째, RL 단계가 frozen retriever와 반복 상호작용을 해야 해서 아주 크거나 자주 바뀌는 database에서는 초기 학습 비용이 커진다. 둘째, 원하는 property를 scalar reward로 쓸 수 있다고 가정한다. creativity나 cultural sensitivity 같은 주관적 선호는 reward로 옮기기 어렵다. 셋째, open-ended 과제의 품질을 LLM judge로 평가했으니 judge 모델의 bias가 섞일 수 있다. 넷째, 특정 fan-out 구조와 diffusion retriever 하나로 실험해서 다른 base model이나 embedding space에서는 결과가 달라질 수 있다.
내가 보기에 더 큰 한계는 평가 도메인이다. fashion outfit과 음악 playlist에서 complementarity는 취향을 넘어 정답의 조건이다. 상의 네 벌이 든 outfit은 심심한 outfit이 아니라 틀린 outfit이다. 그러니 이 두 도메인에서 diversity를 reward에 넣는 건 당연한 설계다. 웹 검색이 그런 도메인인지는 따로 보여야 하고, 이 논문은 그 주장을 하지 않는다.
사실형 질문을 생각하면 차이가 분명해진다. 서로 다른 말을 하는 문서 열 개보다 같은 말을 하는 믿을 만한 문서 세 개가 더 나은 답의 근거다. 거기서 redundancy는 corroboration이고, diversity reward는 그 corroboration을 깎는 방향으로 작동한다. diversity가 좋다는 전제가 평가 도메인에 업혀 들어온 것인지, 검색 일반에 성립하는 것인지는 이 결과만으로 구분되지 않는다.
write-up에도 확인할 점이 있다. 본문은 LLM judge를 Gemini-2.5-Pro로, appendix는 Gemini-2.5-Flash로 적는다 [1]. 음악 dataset은 비공개라 외부에서 재현할 수 없고, conclusion 문단은 fashion benchmark만 언급한다. diversity와 groundedness 점수를 매긴 것도 같은 계열의 LLM judge다.
내가 fan-out을 만든다면
여기부터는 내 독해다. 헤드라인보다 좁게 가져간다. “검색 엔진이 diversity에 reward를 준다”까지는 말할 수 없다. 정답이 서로 보완하는 set이어야 하는 도메인에서 retrieval layer가 그걸 명시적으로 강제하도록 만들어지고 있고, 그게 production latency 안에 들어올 만큼 가벼워졌다는 것까지가 근거 있는 결론이다. 그 위에서 fan-out을 직접 설계한다면 네 가지는 바꾸겠다.
- query를 셀 때 문자열이 아니라 retrieval 결과로 센다. sub-query 10개를 만들었으면 그 결과의 distinct document 수나 Vendi 같은 effective count를 같이 로깅한다. 10개 호출에 distinct 결과가 3개면 그건 비용 문제이기 전에 collapse 신호다. RL까지 가지 않아도 이 지표 하나로 prompt나 sampling 설정을 비교할 수 있다.
- diversity를 고정 목표로 두지 않고 query type별 knob으로 둔다. 추천·탐색형 질문(캠핑 장비)은 complementarity가 정답이고, fact check형 질문은 같은 사실을 확인해주는 source 여러 개가 정답이다. 하나의 diversity 가중치를 모든 query에 걸면 후자에서 corroboration을 깎는다. intent 분류 뒤에 $\lambda_d$를 다르게 주는 쪽이 이 논문 결과와도 덜 충돌한다.
- reward는 항끼리 서로의 shortcut을 막는 구조로 짠다. groundedness 단독이 “line ending” 문자열로 무너진 걸 보면, embedding 기반 reward 하나만 주는 설계는 거의 확실히 hacking 당한다. 새 항을 추가할 때마다 그 항 하나만으로 학습했을 때 어떤 degenerate 출력이 나오는지 먼저 돌려보는 게 싸다.
- distillation은 index가 안정적일 때만 한다. RL 결과를 작은 모델로 굳히는 구조는 latency에는 좋지만 embedding space에 묶인다. corpus나 embedding model이 자주 바뀌는 환경이라면 R4T-FOLM처럼 language model을 그대로 쓰고 batch와 caching으로 비용을 줄이는 쪽이 운영하기 쉽다.
결국 이 논문이 보여준 건 retrieval layer의 설계 방향이다. 그 설계가 내 도메인에서 complementarity 쪽으로 작동할지 corroboration 쪽으로 작동할지는, AI 답변이 같은 질문에 인용하는 source들이 서로 다른 facet을 덮는지 같은 내용을 반복하는지를 직접 관측해서 판단하는 수밖에 없다.
References
- Jiang, Li, Ryu et al., “Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion”, arXiv 2603.06397 (ICML 2026)
- Google Research Blog, “Bypassing inference bottlenecks: Accelerating complex AI search with Retrieve-for-Train” (2026-09-15)
- ICML 2026 poster session page, “Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion”
- Friedman & Dieng, “The Vendi Score: A Diversity Evaluation Metric for Machine Learning”, arXiv 2022
- Han, Wu, Jiang & Davis, “Learning Fashion Compatibility with Bidirectional LSTMs”, ACM MM 2017 (Polyvore dataset)